Inhalt
Reality Check
Stand: Oktober 2026
- Belegt
- 2 Aussagen
Kurz gesagt: Ein verteilter Speicher zerlegt Daten in Stücke, berechnet für jedes Stück, auf welchen Nodes es liegen soll, und legt es dort mehrfach oder als Erasure-Coding-Teile ab. Die Berechnung beachtet Fehlerdomänen, damit ein einzelner Ausfall nicht mehrere Kopien auf einmal trifft. Eine kleine Gruppe von Verwaltungsdiensten hält dabei eine konsistente Karte des Clusters, die alle Beteiligten nutzen. Bestätigt wird ein Schreibvorgang erst, wenn genug Kopien sicher gespeichert sind; fehlt eine, stellt der Cluster sie selbstständig wieder her.
Von außen sieht ein Storage-Cluster aus wie eine Festplatte oder eine Dateifreigabe. Innen passiert bei jedem Schreibvorgang einiges: Daten werden zerlegt, verteilt, mehrfach gespeichert und bestätigt. Dieser Guide schaut unter die Haube, ohne sich auf ein Produkt festzulegen. Als Beispiel dient meist Ceph, weil es die Mechanik besonders gut dokumentiert. Die Grundbegriffe aus Was ist ein Storage-Cluster? setzt er voraus.
Für wen ist dieser Guide? #
- Du willst verstehen, warum ein Cluster sich bei Ausfällen so verhält, wie er sich verhält, statt nur Befehle abzuarbeiten.
- Du planst einen Cluster und willst Begriffe wie Placement Group, CRUSH oder Failure Domain sicher einordnen.
- Du kommst von RAID und ZFS und willst wissen, was im verteilten Fall anders läuft.
Voraussetzungen #
- Die Begriffe Node, Replikation und Quorum aus Was ist ein Storage-Cluster?.
- Für den Praxisteil optional ein Ceph-Testcluster in VMs, zum Beispiel aus Ceph-Testcluster mit drei VMs.
Was du lernst #
- welche Rollen Nodes in einem verteilten Speicher übernehmen,
- wie ein Cluster ohne zentrales Verzeichnis berechnet, wo Daten liegen,
- welche Metadaten es gibt und warum sie besonders geschützt werden,
- wie Replikation und Erasure Coding funktionieren,
- was Konsistenz und Verfügbarkeit im Alltag bedeuten,
- warum Netz und Fehlerdomänen so wichtig sind,
- wie du die Platzierung eines Objekts in einem Ceph-Testcluster selbst nachvollziehst.
Rollen im Cluster #
Nicht jeder Node tut dasselbe. In den meisten Systemen gibt es drei Rollen, die auf getrennten oder auf denselben Servern laufen können.
Datenspeicher. Dienste, die Datenträger verwalten und Datenstücke speichern. In Ceph heißen sie OSD (Object Storage Daemon, ein Dienst pro Datenträger), in LINSTOR sind es die Satellites, die DRBD-Geräte auf ihren lokalen Platten anlegen, in Longhorn die Replikas eines Volumes.
Verwaltung und Abstimmung. Dienste, die den Zustand des Clusters kennen: welche Nodes es gibt, welche erreichbar sind, wie Daten verteilt werden sollen. In Ceph sind das die Monitore (MON), in LINSTOR der Controller. Diese Dienste treffen Entscheidungen und brauchen dafür oft eine Mehrheit, mehr dazu in Replikation, Quorum und Split Brain.
Clients. Alles, was Daten liest und schreibt: ein Hypervisor, ein Kubernetes-Node, eine Anwendung. In Ceph sprechen Clients direkt mit den OSDs, nicht über einen zentralen Vermittler.
Datenplatzierung: Wo landet ein Datenstück? #
Ein Cluster mit Dutzenden Datenträgern muss für jedes Stück Daten wissen, wo es liegt. Dafür gibt es zwei grundsätzliche Ansätze.
Ansatz 1: ein zentrales Verzeichnis #
Die naheliegende Lösung ist eine Tabelle: „Stück 4711 liegt auf Node 2 und Node 5“. Jeder Zugriff fragt zuerst diese Tabelle. Das ist einfach zu verstehen, hat aber zwei Probleme. Die Tabelle wird bei Milliarden Stücken groß, und jeder einzelne Zugriff muss an ihr vorbei. Sie wird zum Engpass und, wenn sie ausfällt, zum Single Point of Failure.
Ansatz 2: den Ort berechnen #
Die Alternative: Der Ort wird aus dem Namen des Datenstücks berechnet. Eine Hash-Funktion macht aus einem beliebigen Namen eine scheinbar zufällige, aber immer gleiche Zahl. Wer den Namen kennt und weiß, wie der Cluster aufgebaut ist, kann den Ort selbst ausrechnen, ohne zu fragen.
Die einfachste Form wäre „Hash modulo Anzahl der Nodes“. Das hat einen gravierenden Nachteil, den eine kurze Rechnung zeigt: Bei vier Nodes landet ein Stück mit dem Hashwert 10 auf Node 10 mod 4 = 2. Kommt ein fünfter Node dazu, landet es auf 10 mod 5 = 0. Rechnet man das für alle Hashwerte durch, wechseln beim Schritt von vier auf fünf Nodes rund vier von fünf Stücken ihren Platz; der Cluster müsste den Großteil seiner Daten umkopieren.
Verteilte Speicher lösen das mit einer zusätzlichen Ebene und einer klügeren Platzierungsregel. Ceph macht es so:
- Daten werden in Objekte zerlegt. Ceph verteilt eine VM-Disk in RBD laut Doku über viele Objekte, deren Maximalgröße konfigurierbar ist. Jedes Objekt hat einen eigenen Namen.
- Objekte werden Placement Groups zugeordnet. Eine Placement Group (PG) ist eine Gruppe von Objekten, die gemeinsam verteilt wird. Die Zuordnung ergibt sich aus dem Hash des Objektnamens. Ein Pool hat eine überschaubare Zahl von PGs, viel weniger als Objekte.
- CRUSH verteilt die PGs auf OSDs. CRUSH ist der Algorithmus, der aus der Cluster-Karte und einer Regel berechnet, welche OSDs für eine PG zuständig sind. Die Regel sorgt dafür, dass die Kopien in verschiedenen Fehlerdomänen liegen, per Default auf verschiedenen Hosts.
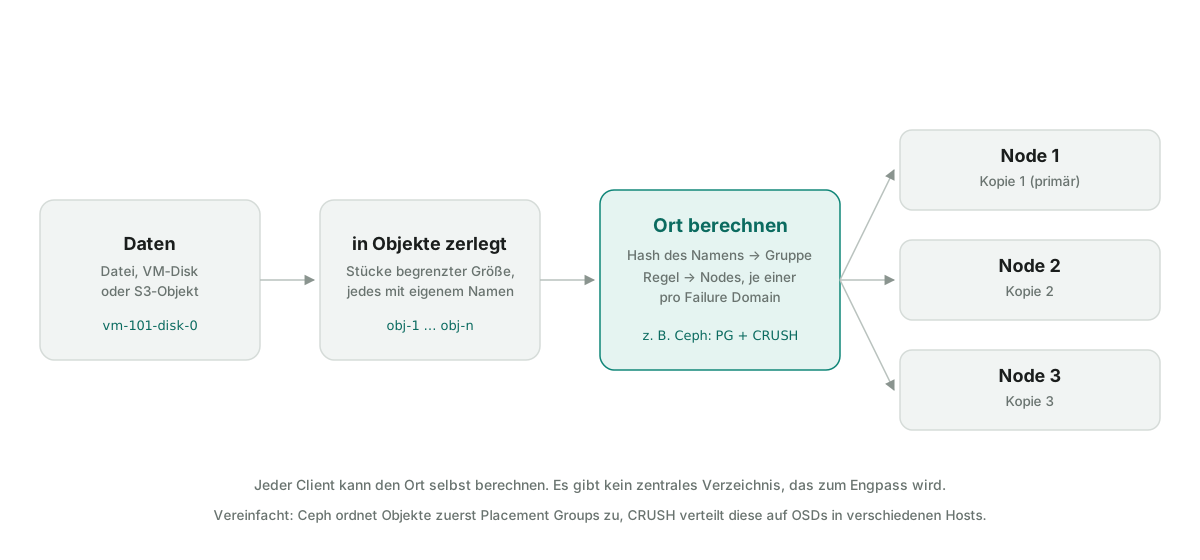
Laut Ceph-Doku ist diese Zwischenschicht der Placement Groups genau das, was dynamisches Umverteilen erlaubt: Ändert sich der Cluster, bewegt Ceph ganze PGs statt jedes einzelne Objekt neu zu berechnen und zu verfolgen.Belegt Und weil Clients und OSDs den Ort selbst berechnen, entfällt die zentrale Nachschlagetabelle.
Andere Systeme lösen die Platzierung anders. LINSTOR entscheidet beim
Anlegen eines Volumes, auf welchen Nodes die Kopien liegen, und speichert
diese Zuordnung in seiner Controller-Datenbank. Die Platzierung ist also
gespeichert statt berechnet, und das ist bei ganzen Volumes statt Milliarden
Objekten auch kein Engpass. Longhorn plant die Replikas eines Volumes per
Default auf verschiedene Kubernetes-Nodes; die Einstellung „Replica Node
Level Soft Anti-Affinity“ steht dafür laut Doku auf false. Das Prinzip
„Kopien in verschiedene Fehlerdomänen“ gilt überall.
Metadaten: die Karte des Clusters #
Neben den eigentlichen Daten braucht ein Cluster Informationen über sich selbst. Man spricht von Metadaten. Dazu gehören:
- die Cluster-Karte: welche Nodes und Datenträger es gibt, welche gerade erreichbar sind, welche Regeln für die Verteilung gelten,
- Zuständigkeiten: welche Datenträger gerade für welche Daten verantwortlich sind,
- bei Dateisystemen zusätzlich: Verzeichnisstruktur, Dateinamen, Berechtigungen.
Diese Informationen müssen auf allen Beteiligten übereinstimmen. Würden zwei Clients verschiedene Karten benutzen, würden sie dieselben Daten an verschiedenen Orten suchen oder ablegen. Deshalb wird die Karte von einer kleinen Gruppe besonders geschützter Dienste verwaltet. In Ceph schreiben die Monitore jede Änderung über das Konsensverfahren Paxos fest und brauchen dafür eine Mehrheit, etwa zwei von drei oder drei von fünf Monitoren.Belegt Die Ceph-Doku nennt das ausdrücklich starke Konsistenz für die Cluster-Karte.
Dateisysteme wie CephFS brauchen zusätzlich einen Metadaten-Dienst (in Ceph der MDS), der Verzeichnisse und Dateinamen verwaltet. Für reinen Blockspeicher entfällt das, weil das Dateisystem dort beim Client liegt.
Replikation: mehrere vollständige Kopien #
Replikation ist das einfachste Schutzverfahren: Jedes Datenstück liegt vollständig auf mehreren Nodes. Interessant ist, wie geschrieben wird.
Ceph nutzt das Primary-Verfahren. Der Client schickt seine Daten an das erste zuständige OSD, das Primary. Dieses ermittelt über seine eigene Kopie der CRUSH-Karte die weiteren zuständigen OSDs, leitet die Daten an sie weiter, wartet auf deren Bestätigung und meldet erst dann dem Client den Erfolg. Ein bestätigter Schreibvorgang liegt also bereits auf allen beteiligten Kopien.
Zwei Einstellungen bestimmen dabei das Verhalten eines replizierten Ceph-Pools:
sizeist die Anzahl der Kopien. Default ist 3.min_sizeist die Mindestzahl erreichbarer Kopien, damit der Pool überhaupt noch Ein- und Ausgaben annimmt. Beisize 3ergibt der Default 2.
Sind weniger als min_size Kopien erreichbar, bestätigt Ceph dem Client
nichts mehr. Die Ceph-Doku warnt ausdrücklich, dass size 2 oder
min_size 1 im Produktivbetrieb das Risiko von Datenverlust birgt und nur in
Notfällen vorübergehend gesetzt werden sollte.
Synchron oder asynchron #
Nicht jedes System wartet auf alle Kopien. DRBD macht den Unterschied gut sichtbar, weil es ihn als Einstellung anbietet:
| DRBD-Protokoll | Schreibvorgang gilt als fertig, wenn … | Folge |
|---|---|---|
| A (asynchron) | lokal geschrieben und das Paket im lokalen Sendepuffer ist | bei erzwungenem Umschalten droht Datenverlust |
| B (halbsynchron) | lokal geschrieben und das Paket beim Partner angekommen ist | Verlust nur in seltenen Doppel-Ausfällen |
| C (synchron) | lokal und auf dem Partner auf Platte geschrieben | Ausfall eines Nodes kostet keine bestätigten Daten |
Der DRBD User Guide nennt Protokoll C das mit Abstand am häufigsten genutzte. Synchrone Replikation kostet Latenz, weil jeder Schreibvorgang auf den langsamsten beteiligten Node wartet. Asynchrone Replikation ist schneller, kann aber die letzten Änderungen verlieren. Ein bekanntes Beispiel für asynchrone Replikation ist die Storage-Replikation von Proxmox mit ZFS, die in Intervallen Snapshots überträgt.
Erasure Coding: Prüfteile statt Kopien #
Dreifache Replikation bedeutet: Für 1 TB Nutzdaten brauchst du 3 TB Speicher. Erasure Coding (EC) ist sparsamer. Es zerlegt jedes Objekt in k Datenteile und berechnet zusätzlich m Prüfteile. Aus beliebigen k dieser k + m Teile lässt sich das Objekt vollständig rekonstruieren. Es dürfen also bis zu m Teile gleichzeitig fehlen.
Der Platzbedarf ergibt sich aus (k + m) geteilt durch k. Zwei Beispiele als Rechnung:
- k = 4, m = 2: 6 Teile für 4 Teile Nutzdaten, also das 1,5-Fache.
- Dreifache Replikation zum Vergleich: das 3-Fache.
Der Preis: Schreiben und Wiederherstellen kosten mehr Rechenleistung, und für die Rekonstruktion eines fehlenden Teils müssen mehrere andere Teile gelesen werden. Außerdem braucht jeder Teil eine eigene Fehlerdomäne. Ceph schreibt, dass die meisten EC-Pools mindestens k + m Fehlerdomänen benötigen; bei Fehlerdomäne Host also mindestens sechs Hosts für k = 4, m = 2. Wer unsicher ist, dem empfiehlt die Ceph-Doku genau dieses Profil, k = 4 und m = 2, und rät von m = 1 für Produktivdaten ausdrücklich ab. Der ausführliche Vergleich steht in Erasure Coding vs. dreifache Replikation.
Konsistenz: Sehen alle dieselben Daten? #
Konsistenz beschreibt, ob alle Leser nach einem Schreibvorgang denselben Stand sehen. Für Speicher sind vor allem zwei Modelle wichtig.
Starke Konsistenz. Sobald ein Schreibvorgang bestätigt ist, liefert jeder nachfolgende Lesevorgang den neuen Stand, egal welche Kopie antwortet. Das erreicht ein System, indem es erst bestätigt, wenn alle zuständigen Kopien geschrieben sind, oder indem es Lesezugriffe immer über eine zuständige Stelle leitet. Block-Speicher für VMs braucht dieses Verhalten: Ein Dateisystem im Gast verlässt sich darauf, dass ein geschriebener Block beim nächsten Lesen genau so zurückkommt.
Letztendliche Konsistenz (Eventual Consistency). Kopien dürfen kurzzeitig voneinander abweichen und gleichen sich später an. Das ist schneller und bleibt bei Netzproblemen eher verfügbar, kann aber kurzzeitig alte Daten liefern. Manche Objekt- und Dateisysteme über weite Entfernungen arbeiten so.
Ceph und DRBD mit Protokoll C bestätigen erst, wenn die Kopien geschrieben sind. Was passiert, wenn das Netz zwischen den Kopien reißt, und warum ein System dann zwischen Konsistenz und Verfügbarkeit wählen muss, erklärt Replikation, Quorum und Split Brain.
Daneben gibt es eine zweite Art von Konsistenz: die Frage, ob gespeicherte Daten mit der Zeit unbemerkt verfälscht werden. Ceph prüft das mit Scrubbing: OSDs vergleichen regelmäßig ihre Kopien. Proxmox beschreibt das als tägliche, günstige Prüfung der Metadaten und wöchentliche gründliche Prüfung der Daten.
Verfügbarkeit: Was passiert bei einem Ausfall? #
Fällt ein Datenträger oder Node aus, durchläuft ein Cluster typischerweise diese Phasen. Am Beispiel Ceph:
- Erkennen. Die übrigen OSDs bemerken, dass ein Partner nicht mehr
antwortet, und melden es den Monitoren. Das OSD gilt als
down. - Weiterarbeiten im degradierten Zustand. Die betroffenen PGs haben
weniger Kopien als vorgesehen. Solange mindestens
min_sizeKopien da sind, laufen Lesen und Schreiben weiter. - Abwarten. Ein OSD, das
downist, ist noch nichtout. Der Cluster wartet eine Weile, ob es zurückkommt, etwa nach einem Neustart. Laut Proxmox-Doku wird ein defektes OSD meist nach zehn Minuten automatisch alsoutmarkiert. - Wiederherstellen. Ist das OSD
out, berechnet CRUSH neue Ziele für die betroffenen PGs, und der Cluster kopiert die fehlenden Daten dorthin. Dieser Vorgang heißt Recovery oder Backfill. - Wieder sauber. Sind alle Kopien vollständig, meldet der Cluster wieder einen gesunden Zustand.
Zwei Begriffe aus Ceph helfen beim Lesen von Statusmeldungen: Das Up Set sind die OSDs, die laut Karte für eine PG zuständig sind, das Acting Set diejenigen, die gerade eine vollständige Kopie haben und Anfragen bedienen. Weichen beide voneinander ab, ist der Cluster mitten in einer Umverteilung.
Wichtig: Schritt 4 braucht freien Platz und eine freie Fehlerdomäne. Ein Cluster aus genau drei Hosts mit dreifacher Replikation kann nach einem Host-Ausfall keine dritte Kopie anlegen, weil kein vierter Host verfügbar ist. Er bleibt degradiert, bis der Host zurück ist.
Netzwerk: der unterschätzte Teil #
In einem verteilten Speicher ist das Netz Teil des Speichers. Zwei Rechnungen zeigen, warum.
Schreiben vervielfacht den Verkehr. Schreibt ein Client 1 GB in einen Ceph-Pool mit dreifacher Replikation, gehen 1 GB vom Client zum Primary und vom Primary je 1 GB zu den beiden weiteren Kopien. Im Netz zwischen den OSDs fließen also 2 GB für 1 GB Nutzdaten.
Wiederherstellung belastet das Netz zusätzlich. Fällt ein Node mit 4 TB belegter Kapazität aus, müssen diese Daten neu verteilt werden. Wie lange das dauert, hängt stark vom Netz ab, daneben von Datenträgern und Recovery-Einstellungen. Die Ceph-Doku nennt für das Replizieren von 1 TiB rund drei Stunden über 1 Gbit/s und rund zwanzig Minuten über 10 Gbit/s.
Ceph erlaubt deshalb zwei getrennte Netze: ein Public Network für Clients und Monitore und ein optionales Cluster Network, über das die OSDs laut Doku Heartbeats, Replikation und Recovery abwickeln. Das trennt die Last, ist aber keine Pflicht; Ceph funktioniert laut eigener Doku auch nur mit einem öffentlichen Netz. Wie du Netz und Bandbreite planst, erklärt Netzwerk für Storage-Cluster; eine Überschlagsrechnung mit eigenen Werten macht der Storage-Netzwerk-Rechner.
Fehlerdomänen: Kopien richtig verteilen #
Drei Kopien nützen wenig, wenn alle drei im selben Server stecken. Deshalb kennt ein verteilter Speicher Fehlerdomänen (Failure Domains). Typische Ebenen sind:
| Ebene | Was gemeinsam ausfallen kann |
|---|---|
| Datenträger | eine Platte |
| Host | Netzteil, Mainboard, Betriebssystem eines Servers |
| Rack | Stromverteilung, Top-of-Rack-Switch |
| Raum oder Standort | Strom, Klima, Brandabschnitt |
Ceph bildet diese Hierarchie in der CRUSH-Karte ab. Neue OSDs werden laut Doku automatisch unter ihrem Host einsortiert, damit Kopien oder EC-Teile auf verschiedene Hosts verteilt werden. Wer mehrere Racks hat, kann die Regel auf Rack-Ebene heben.
Für die Planung folgt daraus eine einfache Regel: Die Anzahl der Kopien oder EC-Teile darf nicht größer sein als die Anzahl der Fehlerdomänen. Sonst müssen zwei Teile in dieselbe Domäne, und ein einzelner Ausfall kostet mehr als einen Teil. Und für die Selbstheilung brauchst du mindestens eine Fehlerdomäne mehr als Teile. Der Storage-Cluster-Kapazitätsrechner warnt, wenn eine Konfiguration diese Regeln verletzt.
Architekturbeispiel: ein Schreibvorgang von Anfang bis Ende #
So sieht ein einzelner Schreibvorgang in einem kleinen Ceph-Cluster aus. Die
Annahmen: drei Hosts node1.example.lan bis node3.example.lan mit je zwei
OSDs, Public Network 192.168.50.0/24, Cluster Network 10.10.10.0/24,
Pool mit size 3 und min_size 2.
- Eine VM schreibt einen Block in ihre virtuelle Disk. Der Hypervisor als Ceph-Client bestimmt, zu welchem Objekt dieser Block gehört.
- Aus dem Objektnamen berechnet der Client die Placement Group und mit CRUSH die drei zuständigen OSDs, je eines auf jedem Host.
- Der Client schickt die Daten über das Public Network an das Primary-OSD,
zum Beispiel auf
node2. - Das Primary schreibt lokal und leitet die Daten über das Cluster Network an
die OSDs auf
node1undnode3weiter. - Beide bestätigen dem Primary. Erst dann bestätigt das Primary dem Client.
- Die VM erhält die Rückmeldung „geschrieben“.
Fällt in diesem Moment node3 aus, sind noch zwei Kopien erreichbar,
min_size ist erfüllt, und die nächsten Schreibvorgänge laufen über die
verbleibenden beiden. Eine dritte Kopie kann der Cluster mangels vierten Hosts
erst wieder anlegen, wenn node3 zurückkommt.
Praxis: Platzierung im Ceph-Testcluster nachvollziehen #
Mit einem Testcluster kannst du sehen, wo Ceph ein Objekt ablegt. Die Befehle folgen der offiziellen Ceph-Dokumentation für Tentacle 20.2, Stand Oktober 2026. LabKompass hat sie für diesen Guide nicht selbst ausgeführt. Gleiche sie vor dem Einsatz mit der Doku deiner Version ab und nutze ausschließlich einen Testcluster ohne wichtige Daten.
Schritt 1: Aufbau ansehen. Diese Befehle lesen nur:
ceph osd tree
ceph osd pool ls detailceph osd tree zeigt die OSDs in ihrer Anordnung unter den Hosts, also die
Fehlerdomänen. ceph osd pool ls detail listet die Pools mit ihren
Einstellungen, darunter size und min_size.
Schritt 2: Replikationseinstellung eines Pools abfragen. Ersetze
testpool durch den Namen eines Pools in deinem Testcluster:
ceph osd pool get testpool size
ceph osd pool get testpool min_sizeSchritt 3: ein Testobjekt speichern. Lege eine kleine Textdatei an und speichere sie als Objekt im Testpool. Das ist der einzige schreibende Schritt:
echo "Hallo Cluster" > testfile.txt
rados put test-object-1 testfile.txt --pool=testpool
rados -p testpool lsSchritt 4: den berechneten Ort abfragen.
ceph osd map testpool test-object-1Die Ausgabe sieht laut Ceph-Doku sinngemäß so aus (Beispiel aus der
Dokumentation mit dem Pool data, deine Werte weichen ab):
osdmap e537 pool 'data' (1) object 'test-object-1' -> pg 1.d1743484 (1.4) -> up ([0,1], p0) acting ([0,1], p0)Lies sie von links nach rechts: Das Objekt gehört zur Placement Group
1.4, das Up Set und das Acting Set sind die OSDs 0 und 1, und p0 heißt,
dass OSD 0 das Primary ist. In einem Pool mit size 3 stehen dort drei OSDs.
Vergleiche die Nummern mit ceph osd tree: Sie sollten auf drei
verschiedenen Hosts liegen.
Schritt 5: aufräumen. Lösche das Testobjekt wieder:
rados rm test-object-1 --pool=testpoolWer möchte, kann zwischen Schritt 4 und 5 einen Test-Node stoppen und den Befehl aus Schritt 4 wiederholen. Du siehst dann, dass das ausgefallene OSD aus Up Set und Acting Set verschwindet. Bei nur drei Hosts bleiben dort zwei OSDs stehen, weil es keinen weiteren Host für die dritte Kopie gibt.
Sicherheitshinweise #
- Nur im Testcluster experimentieren.
rados putundrados rmschreiben und löschen direkt im Speicher, ohne Rückfrage. In einem produktiven Pool kannst du damit Objekte überschreiben, die zu VM-Disks gehören. - Erst lesen, dann ändern. Gewöhne dir an, vor jeder Änderung den Zustand
mit
ceph -sundceph health detailzu prüfen. sizeundmin_sizenicht „zum Testen“ senken. Die Ceph-Doku warnt, dassmin_size 1Datenverlust riskiert. Im Testcluster kannst du es beobachten, produktiv gehört es nur in dokumentierte Notfälle.- Cluster Network nicht routbar machen. Ceph empfiehlt, das Cluster Network weder aus dem öffentlichen Netz noch aus dem Internet erreichbar zu machen.
So prüfst du, ob du es verstanden hast #
Spiele diese Situationen gedanklich oder im Quorum-Simulator durch:
- Ein Pool hat
size 3undmin_size 2. Ein Host fällt aus. Darf der Pool noch schreiben? (Ja, zwei Kopien sind erreichbar.) - Derselbe Pool, zwei von drei Hosts fallen aus. (Nein, nur eine Kopie ist erreichbar, der Pool nimmt keine Ein- und Ausgaben mehr an.)
- Ein EC-Pool mit k = 4, m = 2 und Fehlerdomäne Host in einem Cluster mit fünf Hosts. Was ist das Problem? (Sechs Teile, aber nur fünf Hosts.)
- Ein Client schreibt 10 GB in einen Pool mit dreifacher Replikation. Wie viele Daten fließen zwischen den OSDs? (20 GB.)
Typische Denkfehler #
„Die Daten liegen da, wo ich sie hingeschrieben habe.“ In einem verteilten Speicher entscheidet die Platzierungsregel, nicht der Client. Eine VM-Disk ist über viele Objekte auf alle Hosts verteilt.
„Mehr Kopien sind immer besser.“ Jede Kopie kostet Kapazität, Netz und
Schreiblatenz. Drei Kopien sind in Ceph der Default: Zusammen mit min_size 2
bleibt ein Pool nach einem Ausfall schreibfähig, und es liegen noch zwei
Kopien vor.
„Degradiert heißt kaputt.“ Degradiert heißt nur, dass weniger Kopien
existieren als vorgesehen. Der Cluster arbeitet weiter und repariert sich,
wenn er kann. Kritisch wird es, wenn min_size unterschritten ist.
„Erasure Coding ist einfach sparsamere Replikation.“ EC braucht mehr Fehlerdomänen, mehr Rechenleistung und liest bei der Wiederherstellung deutlich mehr. Für kleine Cluster ist Replikation oft die robustere Wahl.
Offizielle Quellen #
- Ceph Architecture (Tentacle)
- Ceph Monitor Config Reference (Tentacle)
- Ceph CRUSH Maps (Tentacle)
- Ceph Pools (Tentacle)
- Ceph Monitoring OSDs and PGs (Tentacle)
- Ceph Erasure Code (Tentacle)
- Ceph Network Configuration Reference (Tentacle)
- DRBD 9.0 User Guide
- Longhorn 1.13.0 Settings Reference
Weiterlesen #
- Replikation, Quorum und Split Brain: was passiert, wenn das Netz zwischen den Kopien reißt.
- Erasure Coding vs. dreifache Replikation: wann sich der Platzgewinn lohnt und was er kostet.
- Was ist Ceph?: die Bausteine von Ceph im Überblick.
- Netzwerk für Storage-Cluster: wie du Bandbreite, Latenz und Netztrennung planst.
Quellen
Offizielle Dokumentation
Ceph Docs (Tentacle) — Architecture (externer Link, neues Fenster)
Offizielle Dokumentation
Ceph Docs (Tentacle) — Monitor Config Reference (externer Link, neues Fenster)
Offizielle Dokumentation
Ceph Docs (Tentacle) — CRUSH Maps (externer Link, neues Fenster)
Offizielle Dokumentation
Offizielle Dokumentation
Ceph Docs (Tentacle) — Pool, PG and CRUSH Config Reference (externer Link, neues Fenster)
Offizielle Dokumentation
Ceph Docs (Tentacle) — Monitoring OSDs and PGs (externer Link, neues Fenster)
Offizielle Dokumentation
Ceph Docs (Tentacle) — Erasure Code (externer Link, neues Fenster)
Offizielle Dokumentation
Ceph Docs (Tentacle) — Network Configuration Reference (externer Link, neues Fenster)
Offizielle Dokumentation
Offizielle Dokumentation
Longhorn Docs 1.13.0 — Settings Reference (externer Link, neues Fenster)
Häufige Fragen
Woher weiß ein Storage-Cluster, wo meine Daten liegen?
Was ist der Unterschied zwischen Replikation und Erasure Coding?
Was ist eine Fehlerdomäne?
Warum braucht ein verteilter Speicher ein schnelles Netz?
Passt dazu
Werkzeug, Übung und eigene Messung zum Thema.
Teil der Themenwelt Storage Cluster – Verteilten Speicher verstehen und aufbauen · Abschnitt „Grundlagen verteilter Speichersysteme“
Weiterlesen
- Storage ClusterEinsteiger
Was ist ein Storage-Cluster? Einfach erklärt mit Beispielen
Storage-Cluster verständlich erklärt: wie mehrere Server gemeinsam Speicher bereitstellen, was Scale-out, SDS und Shared Storage bedeuten, mit Beispiel.
- Storage ClusterEinsteiger
Storage-Cluster vs. NAS vs. SAN: Unterschiede und Einsatz
NAS, SAN oder Storage-Cluster? Architektur, Ausfallsicherheit, Skalierung, Kosten und Verwaltungsaufwand im Vergleich, für Homelab und kleine Firmen.
- openDeskEinsteiger
Was ist openDesk? Der souveräne Arbeitsplatz einfach erklärt
openDesk ist eine Open-Source-Suite für Dateien, Mail, Chat, Video, Office, Projekte und Wiki auf Kubernetes. Herkunft, Komponenten, Editionen, Grenzen.