Was ist ein Storage-Cluster? Einfach erklärt mit Beispielen
Storage-Cluster verständlich erklärt: wie mehrere Server gemeinsam Speicher bereitstellen, was Scale-out, SDS und Shared Storage bedeuten, mit Beispiel.
Von Niclas Hennrich · Veröffentlicht: · 16 Min. Lesezeit · Einsteiger
Reality Check
Stand: Oktober 2026
- Belegt
- 1 Aussage
- Herstellerangabe
- 1 Aussage
Kurz gesagt: Ein Storage-Cluster fasst die Datenträger mehrerer Server per Software zu einem gemeinsamen Speicher zusammen. Jede Information liegt dabei mehrfach auf verschiedenen Servern, sodass der Ausfall eines Servers weder Daten kostet noch den Betrieb stoppt. Wächst der Platzbedarf, fügst du weitere Server hinzu, statt einen einzelnen zu vergrößern. Der Preis dafür: mindestens drei Server im Dauerbetrieb, ein schnelles Netz und spürbar mehr Komplexität als bei einem NAS.
Wer sich mit Homelab, Proxmox oder Kubernetes beschäftigt, stößt früher oder später auf Namen wie Ceph, LINSTOR oder Longhorn. Alle drei gehören in die Familie der Storage-Cluster. Dieser Guide erklärt das Grundprinzip, ohne vorauszusetzen, dass du schon einmal einen Cluster betrieben hast. Er ist der Einstieg in den Storage-Cluster-Lernpfad.
Für wen ist dieser Guide? #
- Du betreibst ein NAS oder einen einzelnen Server und fragst dich, was ein Cluster anders macht.
- Du planst einen Proxmox-Cluster und willst verstehen, warum dort immer wieder Ceph auftaucht.
- Du willst die Begriffe einordnen können, bevor du dich an eine Installation wagst.
Voraussetzungen #
Keine besonderen. Hilfreich ist, wenn du ungefähr weißt, was ein RAID ist und dass ein Server über das Netzwerk Speicher bereitstellen kann. Wie ein klassisches Backup aufgebaut ist, erklärt Backup-Strategie für zuhause.
Was du lernst #
- was einen Storage-Cluster von einem einzelnen Speicherserver unterscheidet,
- was Scale-out, Software-defined Storage und Hyperkonvergenz bedeuten,
- worin sich Shared Storage und Distributed Storage unterscheiden,
- welche bekannten Systeme es gibt und wofür sie gedacht sind,
- welche Vorteile realistisch sind und welche Kosten und Risiken du einplanen musst.
Die Grundidee: viele Server, ein Speicher #
Stell dir drei Server vor, jeder mit ein paar Festplatten oder SSDs. Ohne Cluster sind das drei getrennte Speicherinseln: Was auf Server 1 liegt, ist weg, sobald Server 1 ausfällt. Ein Storage-Cluster legt eine Software über alle drei, die nach außen wie ein Speicher auftritt. Schreibt eine Anwendung einen Datenblock, entscheidet die Software, auf welchen Servern er landet, und legt ihn dort mehrfach ab.
Ein paar Begriffe brauchst du dafür:
- Node ist ein einzelner Server im Cluster. Manche Nodes speichern Daten, andere übernehmen nur Verwaltungsaufgaben oder dienen als Schiedsrichter.
- Replikation heißt, dass dieselben Daten als vollständige Kopie auf mehreren Nodes liegen. Der Replikationsfaktor sagt, wie viele Kopien es gibt. In Ceph steht er per Default auf drei.
- Erasure Coding ist die platzsparende Alternative: Die Daten werden in Teile zerlegt und um Prüfteile ergänzt, ähnlich wie bei RAID 5 oder 6, nur über Server statt über Platten verteilt.
- Failure Domain (Fehlerdomäne) ist die Einheit, die gemeinsam ausfallen kann, etwa ein Host, ein Rack oder ein Raum. Ein Cluster verteilt Kopien so, dass nie zwei Kopien in derselben Fehlerdomäne liegen, sofern genug Fehlerdomänen vorhanden sind.
- Quorum ist die Regel, dass nur eine Mehrheit der Teilnehmer Entscheidungen treffen darf. Sie soll verhindern, dass zwei getrennte Hälften gleichzeitig weiterarbeiten. Das gelingt aber nur, wenn die Software die Minderheit tatsächlich anhält. Ausführlich erklärt das Replikation, Quorum und Split Brain.
- Self-Healing (Selbstheilung) bedeutet, dass der Cluster nach einem Ausfall fehlende Kopien von sich aus auf anderen Nodes neu anlegt, sofern dort Platz und eine passende Fehlerdomäne frei sind.
Das Entscheidende ist: Kein einzelner Node ist unersetzlich. Ceph beschreibt das in seiner Architektur-Doku so, dass es die zentrale Komponente klassischer Speichersysteme bewusst abschafft, weil sie einen Single Point of Failure darstellt. Clients und Speicherdienste berechnen den Ort der Daten mit dem CRUSH-Algorithmus selbst und brauchen dafür keine zentrale Nachschlagetabelle, die zum Engpass werden könnte.Belegt Wie das im Detail funktioniert, zeigt Wie funktioniert verteilte Datenspeicherung?.
Scale-up und Scale-out #
Wenn ein Speicher zu klein oder zu langsam wird, gibt es zwei Wege.
Scale-up (vertikal skalieren) heißt: denselben Server größer machen. Mehr Platten in das Gehäuse, größere Platten, mehr RAM, ein schnellerer Controller. Das ist einfach, endet aber irgendwann an Grenzen: Einschübe, Steckplätze, das Netzwerk eines einzelnen Geräts. Und der Server bleibt ein einzelner Ausfallpunkt.
Scale-out (horizontal skalieren) heißt: weitere Server danebenstellen. Ein Storage-Cluster ist genau dafür gebaut. Mit jedem Node wächst der Speicherplatz, und weil die Daten verteilt liegen, wächst auch die Zahl der Datenträger und Netzwerkanschlüsse, die gleichzeitig arbeiten können.
| Scale-up | Scale-out | |
|---|---|---|
| Wachstum | größerer Einzelserver | zusätzliche Nodes |
| Ausfall eines Servers | Speicher ist weg, bis er repariert ist | andere Nodes übernehmen |
| Einstiegsaufwand | gering | hoch: mehrere Server, Netz, Software |
| Typische Vertreter | NAS, einzelner ZFS-Server | Ceph, LINSTOR/DRBD, Longhorn |
Scale-out ist nicht automatisch schneller. Jeder Schreibvorgang muss über das Netz an mehrere Nodes gehen und dort bestätigt werden. Ein kleiner Cluster mit langsamem Netz kann sich beim Schreiben träger anfühlen als ein einzelner Server mit lokalen SSDs. Was Performance in Storage-Systemen überhaupt bedeutet, erklärt IOPS, Durchsatz und Latenz.
Software-defined Storage #
Klassische Speichersysteme sind Geräte: Ein Hersteller liefert Hardware, Controller und Firmware als Einheit. Software-defined Storage (SDS) trennt das. Die gesamte Logik, also Replikation, Verteilung, Snapshots und Fehlererkennung, steckt in einer Software, die auf gewöhnlichen Servern läuft. Die Hardware wird austauschbar.
Daraus ergeben sich zwei praktische Folgen:
- Keine RAID-Controller darunter. Die Software will jede Platte direkt sehen, um selbst über Kopien und Fehler zu entscheiden. Proxmox warnt in seiner Ceph-Dokumentation ausdrücklich vor RAID-Controllern und empfiehlt stattdessen einen HBA, also einen einfachen Host Bus Adapter, der Platten nur durchreicht. Die Ceph-Doku bevorzugt ebenfalls einen IT- oder JBOD-Modus.
- Die Qualität der Hardware zählt trotzdem. Ceph nennt günstige Client-SSDs ausdrücklich eine Scheinersparnis und empfiehlt Enterprise-SSDs mit Power Loss Protection (PLP), also einem Schutz, der bei Stromausfall die Daten aus dem SSD-Cache noch sicher schreibt. Details dazu stehen in Welche Hardware braucht ein Storage-Cluster?.
Shared Storage und Distributed Storage #
Zwei Begriffe werden oft verwechselt, obwohl sie Verschiedenes beschreiben.
Shared Storage (gemeinsamer Speicher) heißt nur: Mehrere Server greifen auf denselben Speicher zu. Das kann ein NAS mit NFS-Freigabe sein oder ein SAN, das Blockgeräte über iSCSI bereitstellt. In der Speicherübersicht von Proxmox sind NFS, CIFS, iSCSI und Ceph RBD als „shared“ markiert, ein lokaler ZFS-Pool dagegen nicht. Für Live-Migration von VMs zwischen Hosts brauchst du Shared Storage, aber er muss nicht verteilt sein.
Distributed Storage (verteilter Speicher) heißt: Der Speicher selbst besteht aus vielen Nodes. Ein Storage-Cluster ist immer verteilt und stellt nach außen in der Regel auch Shared Storage bereit.
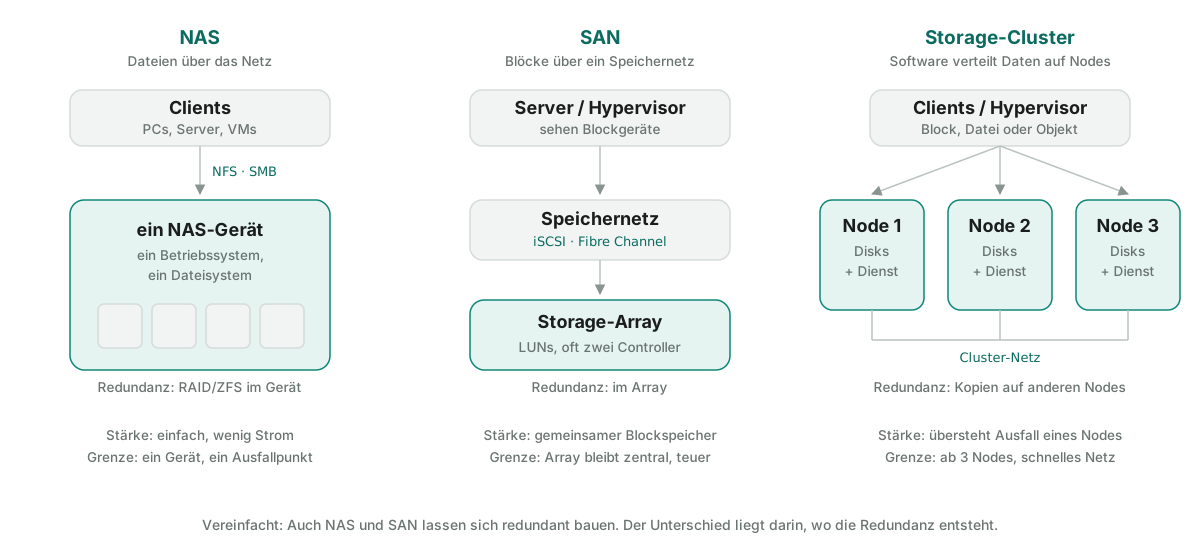
Der Unterschied wird beim Ausfall sichtbar. Fällt das einzige NAS aus, stehen alle VMs, die darauf liegen, obwohl die Hypervisoren selbst laufen. Fällt in einem Storage-Cluster ein Node aus, liegen die Kopien noch auf den anderen. Einen ausführlichen Vergleich mit Kosten, Skalierung und Verwaltung findest du in Storage-Cluster vs. NAS vs. SAN.
Hyperkonvergenz #
Eine Sonderform ist die hyperkonvergente Infrastruktur. Dabei laufen VMs und Storage-Cluster auf denselben Servern: Jeder Proxmox-Node ist gleichzeitig Hypervisor und Ceph-Node. Das spart Geräte, verlangt aber, dass jeder Server genug CPU, RAM und Netzwerk für beides hat. Proxmox empfiehlt dafür, jedem Ceph-Dienst mindestens einen CPU-Kern oder Thread zu reservieren, und nennt für OSDs mindestens 8 GiB RAM für gute Performance.
Block, Datei und Objekt #
Ein Storage-Cluster kann Daten in drei Formen anbieten, und nicht jedes System kann alle drei.
- Block-Speicher verhält sich wie eine virtuelle Festplatte. Ein Hypervisor legt darauf eine VM-Disk ab, das Gastsystem formatiert sie selbst. Beispiele: Ceph RBD, DRBD-Geräte, Longhorn-Volumes.
- Datei-Speicher ist ein Dateisystem, das mehrere Clients gleichzeitig einhängen können, ähnlich einer NFS-Freigabe. Beispiele: CephFS, GlusterFS.
- Objekt-Speicher speichert Dateien als Objekte über eine HTTP-Schnittstelle, meist kompatibel zu Amazon S3. Beispiel: Ceph RGW.
Welche Form für welchen Zweck passt, vertieft RBD, CephFS oder Object Storage?.
Bekannte Systeme im Überblick #
Die folgende Tabelle ordnet die häufigsten Namen ein. Die Versionen sind der Stand Oktober 2026 laut den jeweiligen offiziellen Quellen.
| System | Was es ist | Speicherformen | Stand Oktober 2026 |
|---|---|---|---|
| Ceph | verteilter Objektspeicher als Basis, darauf Block, Datei, S3 | Block, Datei, Objekt | Tentacle 20.2.4 |
| DRBD mit LINSTOR | Replikation einzelner Blockgeräte zwischen Nodes, LINSTOR verwaltet sie | Block | DRBD 9.3.4, LINSTOR 1.35.2 |
| Longhorn | verteilter Blockspeicher speziell für Kubernetes | Block (Datei über NFS) | v1.13.0 |
| GlusterFS | verteiltes Dateisystem | Datei | 11.2 (Juli 2025), Entwicklung verlangsamt |
| ZFS mit Replikation | kein Cluster: lokales Dateisystem, zeitversetzt auf zweiten Server kopiert | Block, Datei | OpenZFS 2.4.4 |
Einige Einordnungen dazu:
- Ceph ist das umfassendste und zugleich anspruchsvollste System. Proxmox VE 9.2 bringt es integriert mit, bei Neuinstallation standardmäßig in der Version Tentacle 20.2. Einstieg: Was ist Ceph?.
- DRBD repliziert ein Blockgerät synchron auf andere Nodes, LINSTOR automatisiert das für viele Volumes. Der DRBD User Guide nennt für Quorum mindestens drei Nodes, wobei der dritte keine Daten speichern muss. Mehr in LINSTOR und DRBD verstehen.
- Longhorn läuft nur innerhalb von Kubernetes und setzt für Version 1.13.0 Kubernetes ab v1.34 voraus. Die Default-Replikazahl liegt bei drei.
- GlusterFS: Red Hats kommerzielles Produkt auf GlusterFS-Basis hat Ende 2024 sein Supportende erreicht; das Open-Source-Projekt arbeitet laut einem Maintainer mit wenigen Personen weiter. Für neue Installationen ist es deshalb kaum noch die erste Wahl, Details in GlusterFS: Architektur, Status und Alternativen.
- ZFS gehört in diese Tabelle, weil es oft als Alternative auftaucht. Ein
ZFS-Pool ist laut OpenZFS-Doku immer nur auf einem Host aktiv; die
Eigenschaft
multihostverhindert sogar ausdrücklich, dass ein aktiver Pool ein zweites Mal importiert wird. Proxmox kann ZFS-Volumes per Storage-Replikation in Intervallen ab einer Minute auf andere Nodes kopieren. Zwischen zwei Läufen geänderte Daten gehen bei einem Ausfall aber verloren. Die ZFS-Grundlagen erklärt der ZFS-Lernpfad.
Ein Architekturbeispiel: drei Nodes mit dreifacher Replikation #
Um das Zusammenspiel greifbar zu machen, ein typischer kleiner Aufbau:
- Drei Server
node1.example.lan,node2.example.lan,node3.example.lan, jeder mit zwei SSDs für den Cluster. - Ein Netz für Clients und Verwaltung,
192.168.50.0/24, und ein getrenntes Cluster-Netz10.10.10.0/24nur für den Austausch der Nodes untereinander. - Ceph mit den Pool-Defaults
size 3(drei Kopien) undmin_size 2(Schreiben nur, solange mindestens zwei Kopien erreichbar sind).
Was passiert in verschiedenen Situationen?
| Situation | Was der Cluster tut |
|---|---|
| Normalbetrieb | Jeder Block liegt auf allen drei Nodes, je einmal pro Host. |
| Eine SSD fällt aus | Die betroffenen Daten sind noch zweimal vorhanden. Ceph stellt die fehlende Kopie auf der anderen SSD desselben Hosts wieder her, wenn dort Platz ist. |
| Ein Node fällt aus | Zwei Kopien sind übrig, min_size 2 ist erfüllt, Lesen und Schreiben laufen weiter. Eine dritte Kopie kann der Cluster aber nirgends anlegen, weil kein weiterer Host frei ist. Er läuft degradiert, bis der Node zurück ist. |
| Zwei Nodes fallen aus | Nur noch eine Kopie, min_size ist unterschritten, und laufen die Monitore auf denselben Nodes, fehlt auch deren Mehrheit. Ceph bedient keine Zugriffe mehr. Die Daten sind nicht verloren, aber erst wieder erreichbar, wenn ein Node zurückkommt. |
Die dritte Zeile ist eine wichtige Erkenntnis für kleine Cluster: Mit genau drei Nodes und drei Kopien übersteht der Cluster einen Node-Ausfall, kann sich aber nicht selbst heilen. Ab vier Nodes gibt es ein Ziel für die Wiederherstellung, sofern dort genug Kapazität frei ist. Ceph markiert ein ausgefallenes OSD laut Proxmox-Doku nach etwa zehn Minuten als „out“ und beginnt dann mit dem Umverteilen, wenn ein Ziel verfügbar ist.
Wofür Storage-Cluster eingesetzt werden #
- VM-Speicher für Hypervisor-Cluster. Liegen VM-Disks auf einem Storage-Cluster, kann jede VM auf jedem Host starten. Live-Migration und automatischer Neustart auf einem anderen Host nach einem Ausfall werden so erst möglich. Das ist der häufigste Grund für Ceph in Proxmox-Umgebungen.
- Persistenter Speicher für Kubernetes. Container wandern zwischen Nodes; ihre Daten müssen mitkommen. Longhorn, Rook-Ceph und LINSTOR über den Piraeus Operator lösen das. Grundlagen in Persistent Storage in Kubernetes verstehen.
- Objektspeicher. Wer intern einen S3-kompatiblen Speicher für Backups, Medien oder Anwendungen braucht, kann ihn mit Ceph RGW selbst betreiben.
- Wachsende Datenmengen. Wenn absehbar ist, dass ein einzelner Server nicht reicht, wächst ein Cluster Node für Node mit.
- Lernen. Im Homelab ist ein kleiner Cluster in VMs ein sehr guter Weg, verteilte Systeme zu verstehen, ohne echte Daten zu riskieren.
Vorteile und Nachteile ehrlich betrachtet #
Was ein Storage-Cluster dir bringt:
- Ausfallsicherheit auf Serverebene. Ein Node darf ausfallen, auch ein ganzer Server mit Netzteil und Mainboard, nicht nur eine Platte.
- Wartung ohne Stillstand. Du kannst einen Node für Updates oder Hardwaretausch herunterfahren, während die anderen weiterlaufen.
- Wachstum in kleinen Schritten. Weitere Nodes oder Platten erweitern den Speicher, ohne die vorhandenen zu ersetzen.
- Gemeinsamer Speicher für alle Hosts. Grundlage für Live-Migration und Hochverfügbarkeit von VMs.
Was er kostet:
- Mindestens drei Server, dauerhaft eingeschaltet. Ein Cluster lebt davon, dass die Mehrheit seiner Nodes läuft. Drei Server ziehen rund um die Uhr Strom. Wie viel, hängt stark von der Hardware ab; rechne es mit eigenen Werten im Stromkosten-Rechner nach.
- Ein schnelles, verlässliches Netz. Jede Schreiboperation geht an mehrere Nodes. Die Ceph-Doku empfiehlt mindestens 10 Gbit/s zwischen den Hosts und rechnet vor, dass das Replizieren von 1 TiB über 1 Gbit/s rund drei Stunden dauert, über 10 Gbit/s rund zwanzig Minuten.Herstellerangabe Proxmox empfiehlt ebenfalls mindestens 10 Gbit/s exklusiv für den Ceph-Verkehr.
- Viel RAM. Ein Ceph-OSD, also der Dienst, der einen Datenträger im Cluster verwaltet, zielt per Default auf 4 GiB Arbeitsspeicher. Bei sechs OSDs pro Node sind das bereits 24 GiB nur für die Speicherdienste, bevor eine einzige VM läuft.
- Kapazitätsverlust. Bei dreifacher Replikation bleibt rechnerisch ein Drittel der Bruttokapazität nutzbar, und davon solltest du nicht alles belegen (siehe Rechenbeispiel unten).
- Komplexität. Ein Cluster hat mehr Zustände, mehr Fehlerbilder und mehr Wartungsschritte als ein NAS. Updates müssen in der richtigen Reihenfolge erfolgen, Warnungen wollen verstanden werden.
- Kein Ersatz für ein Backup. Ein Cluster schützt vor Hardwareausfall, nicht vor Fehlbedienung, Ransomware oder Softwarefehlern. Warum, erklärt Replikation ist kein Backup.
Rechenbeispiel: Wie viel Platz bleibt übrig? #
Ein Beispiel mit offengelegten Annahmen, nachrechenbar im Storage-Cluster-Kapazitätsrechner:
- Annahme: vier Nodes mit je zwei Datenträgern zu 4 TB, also 32 TB brutto.
- Annahme: dreifache Replikation, Failure Domain Host.
- Annahme: Füllgrenze 85 %, weil Ceph per Default ab diesem Wert
OSD_NEARFULLmeldet.
Die Rechnung:
- Nutzbar ohne Reserve: 32 TB geteilt durch 3 ergibt rund 10,7 TB.
- Bis zur Füllgrenze: 10,7 TB mal 0,85 ergibt rund 9,1 TB.
- Mit Reserve für einen Node-Ausfall: Fällt einer der vier Nodes aus, müssen alle Daten mit drei Kopien auf die übrigen drei passen. Das sind 24 TB brutto, geteilt durch 3 ergibt 8 TB, davon 85 % ergibt rund 6,8 TB.
Von 32 TB gekauften Datenträgern solltest du in diesem Beispiel also nur gut ein Fünftel fest verplanen. Die Rechnung lässt Metadaten, Dateisystem-Overhead und ungleichmäßige Verteilung noch außen vor; reale Werte liegen darunter. Mit nur drei Nodes liefert der Rechner für Schritt 3 den Wert null, weil nach einem Node-Ausfall kein vierter Host für die Wiederherstellung bereitsteht.
Ausprobieren in einer Testumgebung #
Am meisten lernst du, wenn du einen Cluster selbst aufbaust und dann absichtlich Dinge kaputt machst. Dafür brauchst du keine drei echten Server.
- Lege auf einem Rechner mit genug RAM drei VMs an, jede mit einer kleinen Systemplatte und mindestens einer zusätzlichen leeren virtuellen Platte.
- Gib den VMs ein eigenes, isoliertes Netz, damit Experimente nichts in deinem Heimnetz stören.
- Installiere dort einen Cluster nach Anleitung, etwa Ceph-Testcluster mit drei VMs.
- Beobachte den Zustand mit lesenden Befehlen. Bei Ceph sind das zum Beispiel die folgenden; sie stammen aus der offiziellen Ceph-Dokumentation (Tentacle 20.2, Stand Oktober 2026), LabKompass hat sie für diesen Guide nicht selbst ausgeführt:
ceph -s
ceph osd tree
ceph health detailceph -s zeigt den Gesamtzustand, ceph osd tree die OSDs in ihrer
Anordnung nach Hosts, ceph health detail die Ursachen von Warnungen.
- Stoppe dann eine VM und sieh zu, wie der Cluster reagiert: Warnungen, degradierte Daten, später die Erholung nach dem Neustart.
Vor dem echten Aufbau kannst du Ausfälle auch gedanklich durchspielen: Der Quorum-Simulator zeigt, wann ein Cluster mit zwei, drei oder fünf Nodes nach einem Ausfall noch schreiben darf.
Sicherheitshinweise #
- Cluster-Netz abschotten. Die Ceph-Doku empfiehlt, das Cluster-Netz weder aus dem öffentlichen Netz noch aus dem Internet erreichbar zu machen. Speicherverkehr gehört in ein eigenes Segment.
- Admin-Schlüssel schützen. Wer den Admin-Schlüssel eines Clusters hat, kann alle Daten lesen und löschen. Ceph beschreibt den beim Einrichten erzeugten Admin-Keyring ausdrücklich als privilegierten Schlüssel.
- Updates nicht aufschieben. Ceph 20.2.4 ist ein reines Security-Release, das unter anderem eine Lücke in der Authentifizierung schließt. Die Ceph-Entwickler empfehlen das Update allen Nutzern.
- Mit Testdaten üben. Befehle, die Datenträger löschen oder Daten verwerfen, gehören in die Testumgebung, nie in den ersten Versuch mit echten Daten.
Ein eigener Guide zum Thema folgt in Storage-Cluster absichern.
Verständnis prüfen #
Du hast das Grundprinzip verstanden, wenn du diese Fragen beantworten kannst:
- Warum braucht ein Cluster in der Regel mindestens drei Nodes und nicht zwei?
- Warum kann ein Cluster mit drei Nodes und drei Kopien einen Node-Ausfall überstehen, sich aber nicht selbst heilen?
- Was ist der Unterschied zwischen Shared Storage und Distributed Storage?
- Warum sollte unter einem Storage-Cluster kein RAID-Controller arbeiten?
- Warum ersetzt ein Cluster kein Backup?
Wenn eine Antwort wackelt, lies den passenden Abschnitt noch einmal oder spiel die Situation im Quorum-Simulator durch.
Typische Missverständnisse #
„Mehr Nodes sind immer schneller.“ Nicht unbedingt. Mehr Nodes verteilen die Last, aber jede Schreiboperation wartet auf die Bestätigung mehrerer Kopien. Ein langsames oder überlastetes Netz bremst den ganzen Cluster.
„Zwei Server reichen für Hochverfügbarkeit.“ Bei einer Netzwerktrennung hat keiner der beiden die Mehrheit. Entweder halten dann beide an, oder es droht ein Split Brain mit zwei unterschiedlichen Datenständen. Eine dritte Stimme, zum Beispiel ein Witness ohne Daten, löst das Patt, vorausgesetzt, die Software setzt die Mehrheitsregel auch durch.
„Der Cluster ist mein Backup.“ Eine gelöschte Datei ist auf allen Kopien gleichzeitig gelöscht. Ohne getrenntes Backup ist sie weg.
„Billige SSDs sind gut genug, es gibt ja drei Kopien.“ Kopien schützen vor Ausfall, nicht vor schlechter Performance. Günstige SSDs ohne PLP können unter Dauerschreiblast stark einbrechen und bremsen dann den ganzen Cluster.
„Ein voller Cluster ist effizient.“ Ceph blockiert per Default
Schreibzugriffe, sobald ein OSD die Schwelle mon_osd_full_ratio von 95 %
überschreitet. Ein zu voller Cluster
kann sich nach einem Ausfall außerdem nicht mehr selbst heilen.
Offizielle Quellen #
- Ceph Architecture (Tentacle)
- Ceph Hardware Recommendations (Tentacle)
- Ceph Pool, PG and CRUSH Config Reference (Tentacle)
- Proxmox VE: Deploy Hyper-Converged Ceph Cluster
- Proxmox VE: Storage
- DRBD 9.0 User Guide
- Longhorn 1.13.0 Settings Reference
- OpenZFS zpoolprops.7
- Red Hat Gluster Storage Life Cycle
Weiterlesen #
- Storage-Cluster vs. NAS vs. SAN: der direkte Vergleich der drei Architekturen mit Kosten, Skalierung und Verwaltung.
- Wie funktioniert verteilte Datenspeicherung?: wie ein Cluster entscheidet, wo welche Daten liegen, und was bei Ausfällen passiert.
- Wann lohnt sich ein Storage-Cluster wirklich?: die Entscheidungshilfe, ob NAS, ZFS oder Cluster zu deinem Bedarf passt.
- Replikation ist kein Backup: warum du trotz drei Kopien eine getrennte Sicherung brauchst.
Quellen
Offizielle Dokumentation
Ceph Docs (Tentacle) — Architecture (externer Link, neues Fenster)
Offizielle Dokumentation
Ceph Docs (Tentacle) — Hardware Recommendations (externer Link, neues Fenster)
Offizielle Dokumentation
Ceph Docs (Tentacle) — Pool, PG and CRUSH Config Reference (externer Link, neues Fenster)
Offizielle Dokumentation
Proxmox VE Admin Guide — Deploy Hyper-Converged Ceph Cluster (externer Link, neues Fenster)
Offizielle Dokumentation
Proxmox VE Admin Guide — Proxmox VE Storage (externer Link, neues Fenster)
Offizielle Dokumentation
Offizielle Dokumentation
Longhorn Docs 1.13.0 — Settings Reference (externer Link, neues Fenster)
Offizielle Dokumentation
OpenZFS Docs — zpoolprops.7 (multihost) (externer Link, neues Fenster)
Hersteller
Red Hat — Red Hat Gluster Storage Life Cycle (externer Link, neues Fenster)
Häufige Fragen
- Was ist ein Storage-Cluster in einem Satz?
- Ein Storage-Cluster ist ein Verbund aus mehreren Servern, deren Datenträger eine Software zu einem gemeinsamen Speicher zusammenfasst und dabei jede Information auf mehreren Servern ablegt. Fällt ein Server aus, sind die Daten über die anderen weiter erreichbar.
- Wie viele Server braucht ein Storage-Cluster mindestens?
- Für einen verlässlichen Betrieb in der Regel drei. Proxmox nennt für hyperkonvergentes Ceph ausdrücklich mindestens drei Server, DRBD braucht für Quorum drei Teilnehmer, wobei der dritte keine Daten speichern muss. Mit zwei Servern fehlt bei einer Netzwerktrennung die entscheidende Mehrheit.
- Ist ein Storage-Cluster ein Backup?
- Nein. Ein Cluster repliziert jede Änderung sofort auf alle Kopien, also auch ein versehentliches Löschen oder eine Verschlüsselung durch Ransomware. Ein Backup ist eine getrennte, ältere Kopie, auf die du zurückgehen kannst. Beides ergänzt sich, ersetzt sich aber nicht.
- Ist ZFS ein Storage-Cluster?
- Nein. ZFS ist ein Dateisystem und Volume-Manager für einen einzelnen Server. Ein ZFS-Pool ist immer nur auf einem Host aktiv. Mit zfs send und receive lassen sich Daten zwar auf einen zweiten Server kopieren, das ist aber eine zeitversetzte Replikation und kein gemeinsamer, verteilter Speicher.
- Ist jeder Shared Storage ein Storage-Cluster?
- Nein. Shared Storage heißt nur, dass mehrere Server auf denselben Speicher zugreifen, etwa auf eine NFS-Freigabe eines NAS. Fällt dieses eine Gerät aus, ist der Speicher weg. Ein Storage-Cluster verteilt den Speicher selbst auf mehrere Nodes und stellt ihn nach außen meist ebenfalls als Shared Storage bereit.
Teil des Themen-Hubs Storage Cluster – Verteilten Speicher verstehen und aufbauen · Abschnitt „Grundlagen verteilter Speichersysteme“
Weiterlesen
Storage Cluster
Storage-Cluster vs. NAS vs. SAN: Unterschiede und Einsatz
NAS, SAN oder Storage-Cluster? Architektur, Ausfallsicherheit, Skalierung, Kosten und Verwaltungsaufwand im Vergleich, für Homelab und kleine Firmen.
Hardware
Warum sind Festplatten, SSDs und Grafikkarten gerade so teuer?
NAS-Platten und NVMe-SSDs kosten 2026 rund das Zweieinhalbfache des Vorjahres, Grafikkarten ziehen nach. Woher das kommt, was belegt ist — und was das für dein NAS oder deinen Homeserver heißt.
Neuromorphic Computing
Wie rechnet ein Netz mit Impulsen? Spiking Neural Networks erklärt
Was ein Spike-Neuron ist, wie das Leaky-Integrate-and-Fire-Modell funktioniert, wie SNNs Information kodieren und trainiert werden — mit kleinem Python-Beispiel.