Inhalt
Reality Check
Stand: Oktober 2026
- Herstellerangabe
- 2 Aussagen
Kurz gesagt: Für Ceph und Proxmox-Hochverfügbarkeit sind drei Nodes das dokumentierte Minimum, Longhorn empfiehlt ebenfalls drei. Mit zwei Daten-Nodes kommst du vor allem bei DRBD/LINSTOR oder bei Proxmox ohne Ceph aus, und auch dann nur mit einem dritten Teilnehmer ohne Daten (Witness, Tiebreaker oder QDevice), der bei einer Netztrennung die Mehrheit herstellt. Fünf Nodes überstehen zwei Ausfälle im Quorum und geben Ceph Platz, verlorene Kopien auf andere Server neu zu verteilen. Vier Nodes verbessern das Quorum gegenüber drei nicht, helfen Ceph aber bei der Wiederherstellung.
„Wie viele Server brauche ich?“ ist die erste Frage beim Planen eines Storage-Clusters, und die Antwort hängt nicht vom Geschmack ab, sondern von zwei Mechanismen: Wer darf im Streitfall entscheiden, und wo können Kopien liegen? Wer beides versteht, kann die Mindestgrößen der einzelnen Systeme nachvollziehen, statt sie auswendig zu lernen.
Für wen ist dieser Guide? Für alle, die vor der Entscheidung stehen, zwei, drei, vier oder fünf Server für einen Storage-Cluster anzuschaffen, im Homelab genauso wie im kleinen Unternehmen. Du musst noch keine der Technologien installiert haben.
Voraussetzungen: Du kennst die Begriffe Replikation, Quorum und Split Brain. Falls nicht, lies zuerst Replikation, Quorum und Split Brain.
Was du lernst:
- wie du die nötige Mehrheit und die Zahl verkraftbarer Ausfälle für jede Cluster-Größe ausrechnest,
- welche Mindestgröße Ceph, Proxmox VE, DRBD/LINSTOR, Longhorn und GlusterFS laut ihrer Dokumentation verlangen,
- was ein Witness leistet und was nicht,
- warum drei Nodes für Ceph funktionieren, aber knapp sind,
- wie viel Speicherplatz du für den Ausfall eines Nodes freihalten musst,
- wie du das Verhalten im Quorum-Simulator und in einer Testumgebung nachvollziehst.
Hinweis zum Stand: Mindestgrößen und Befehle folgen der offiziellen Dokumentation, Stand Oktober 2026: Ceph 20.2 Tentacle, Proxmox VE 9.2, DRBD 9 und LINSTOR (LINBIT User Guides), Longhorn 1.13.0 und Kubernetes 1.37. LabKompass hat die Befehle für diesen Guide nicht selbst ausgeführt. Die Kapazitätsrechnungen sind Ableitungen aus dokumentierten Schwellenwerten, keine Messungen. Probiere Ausfallszenarien zuerst in einer Testumgebung aus, nie im produktiven Cluster.
Drei Fragen bestimmen die Node-Zahl #
- Quorum: Wer darf entscheiden? Ein Cluster muss jederzeit wissen, welche Nodes dazugehören und wer schreiben darf. Fällt das Netz zwischen zwei Gruppen von Nodes aus, darf nur eine Gruppe weitermachen, sonst schreiben beide Seiten unabhängig voneinander, und es entstehen zwei unterschiedliche Datenstände (Split Brain). Die übliche Regel: Nur die Gruppe mit der Mehrheit der Stimmen darf weitermachen.
- Datenkopien: Wo können Kopien liegen? Ein Cluster mit dreifacher Replikation, der jede Kopie auf einem anderen Server ablegen will, braucht mindestens drei Server. Damit er nach einem Ausfall eine verlorene Kopie neu anlegen kann, braucht er einen weiteren Server, auf dem diese Kopie noch nicht liegt.
- Kapazität, Strom und Kosten: Jeder weitere Node kostet Anschaffung, Strom und Pflege, verteilt aber auch die Last und verkleinert den Anteil, der bei einem Ausfall wegfällt.
Eine wichtige Einschränkung vorweg: Quorum schützt nur, wenn die Minderheit tatsächlich anhält. Die Software muss die Mehrheitsregel durchsetzen, und Nodes, die ihre Verbindung verloren haben, müssen sich zuverlässig zurückziehen. Bei Proxmox übernimmt das ein Watchdog, der einen Node ohne Quorum neu startet (Fencing); bei DRBD stellt die Ressource auf einem Node ohne Quorum je nach Einstellung I/O ein oder liefert Fehler. Drei Nodes verhindern Split Brain also nicht von selbst, sondern nur zusammen mit diesen Mechanismen. Die Details stehen im Guide Replikation, Quorum und Split Brain.
Mehrheit rechnen #
Die Mehrheit ist immer „mehr als die Hälfte“ der Stimmen. Die Ceph-Doku nennt als Beispiele 2 von 3, 3 von 5 und 4 von 6 Monitoren. Daraus ergibt sich, wie viele Ausfälle ein Cluster verkraftet, ohne das Quorum zu verlieren:
| Stimmen | nötige Mehrheit | verkraftbare Ausfälle |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
| 6 | 4 | 2 |
| 7 | 4 | 3 |
Zwei Dinge fallen auf:
- Zwei Stimmen sind nicht besser als eine. Fällt eine aus, hat die verbleibende keine Mehrheit. Schlimmer noch: Bei einer Netztrennung hat keine Seite die Mehrheit, der Cluster steht.
- Gerade Zahlen bringen beim Quorum nichts. Vier Stimmen verkraften genauso einen Ausfall wie drei, sechs genauso zwei wie fünf. Deshalb empfehlen die Dokumentationen für Abstimmungsdienste ungerade Zahlen: Rook nennt für höchste Verfügbarkeit eine ungerade Zahl von Ceph-Monitoren, die Kubernetes-Doku empfiehlt für etcd eine ungerade Zahl von Mitgliedern.
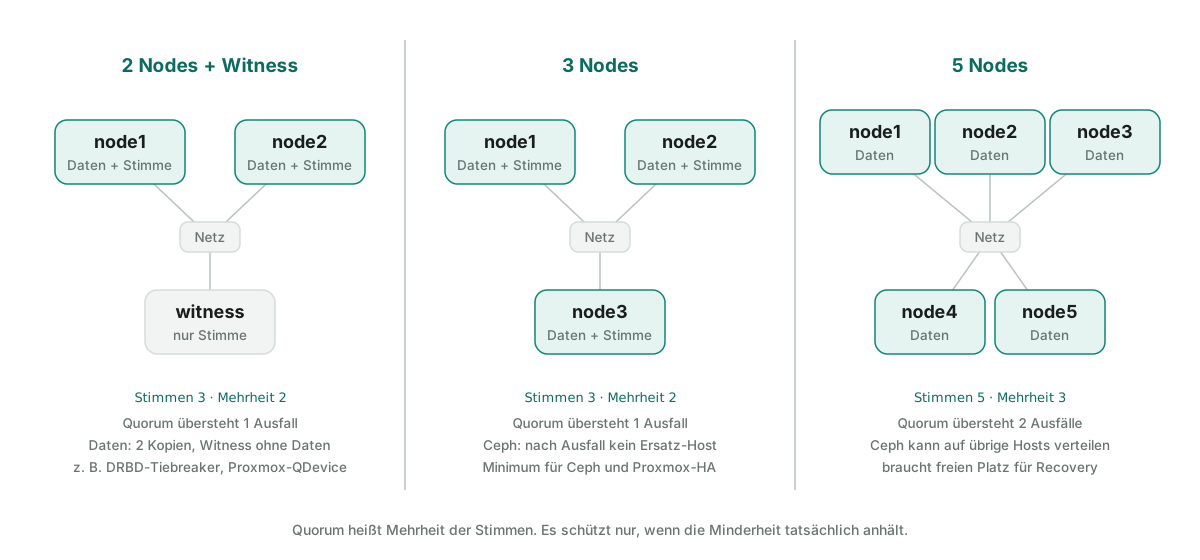
Die Stimmen im Quorum und die Kopien der Daten sind zwei getrennte
Dinge. Ein Cluster kann das Quorum behalten und trotzdem für einzelne
Daten nicht mehr schreiben dürfen, weil zu wenige Kopien erreichbar sind.
Bei Ceph regelt das der Pool-Parameter min_size (dazu gleich mehr).
Mindestgrößen je Technologie #
| Technologie | Minimum laut Doku | Zwei Daten-Nodes möglich? | Empfehlung für mehr Sicherheit |
|---|---|---|---|
| Ceph (cephadm) | 3 Monitore für Produktion; 3 Kopien auf 3 Hosts | nein, nicht mit Standardwerten | 5 Monitore ab 5 Nodes |
| Proxmox VE + Ceph | mindestens 3, möglichst identische Server | nein | 12+ OSDs, gleichmäßig verteilt |
| Proxmox VE ohne Ceph | 3 Nodes für HA | ja, mit QDevice als 3. Stimme | QDevice nur bei gerader Node-Zahl |
| DRBD/LINSTOR | 3 Nodes für Quorum, der dritte darf ohne Daten sein | ja, mit Diskless-Tiebreaker | 3 Nodes mit Daten |
| Longhorn | Empfehlung: 3 Nodes | ja, laut Doku dann 2 Replikas pro Volume | 3 Nodes, Kubernetes-Steuerung separat beachten |
| GlusterFS | Replica 3 oder Replica 2 mit Arbiter | ja, mit Arbiter-Brick | für neue Deployments nicht empfohlen |
Ceph #
Ceph-Monitore stimmen per Paxos ab und brauchen eine Mehrheit. Die Doku empfiehlt für einen produktiven Cluster mindestens drei Monitore. Die cephadm-Doku ergänzt: Ein typischer Cluster hat drei oder fünf Monitore auf verschiedenen Hosts; ab fünf Nodes empfiehlt sie fünf Monitore, und die meisten Cluster profitieren nicht von sieben oder mehr.
Für die Daten gilt: Ein neuer Pool hat standardmäßig size 3, also drei
Kopien. CRUSH, der Algorithmus, der die Speicherorte berechnet, legt OSDs
standardmäßig unter einem Host ab und verteilt Kopien so, dass sie auf
verschiedenen Hosts landen. Drei Kopien brauchen also drei Hosts.
min_size steht bei size 3 rechnerisch auf 2: Ceph bestätigt Schreib-
und Lesezugriffe auf eine Placement Group nur, solange mindestens zwei
Kopien verfügbar sind.
Mit zwei Hosts funktioniert das nicht: Eine dritte Kopie hat keinen Platz,
und zwei Monitore verkraften keinen Ausfall. Die cephadm-Option
--single-host-defaults stellt Ceph auf einen einzigen Host um, mit zwei
Kopien und Verteilung über OSDs statt über Hosts; die Doku schreibt
selbst, solche Cluster seien für den Produktivbetrieb in der Regel nicht
geeignet. Und die Pool-Doku warnt: size 2 oder min_size 1 im
Produktivbetrieb riskieren Datenverlust und sollten nur vorübergehend in
Notfällen gesetzt werden.
Der Stretch Mode von Ceph wird manchmal als Zwei-Node-Lösung missverstanden. Er ist für zwei Rechenzentren gedacht: zwei Monitore in jedem Rechenzentrum plus ein Tiebreaker-Monitor an einem dritten Ort, also fünf Monitore. Die Pools wachsen dabei auf vier Kopien, Erasure Coding ist nicht möglich, und die Doku empfiehlt ihn nur mit SSD-OSDs. Der Tiebreaker darf laut Doku eine VM sein. Für ein Homelab mit zwei Servern ist das keine Abkürzung.
Proxmox VE mit und ohne Ceph #
Die Proxmox-Doku verlangt für einen hyperkonvergenten Cluster aus Proxmox VE und Ceph mindestens drei, möglichst identische Server und empfiehlt mindestens zwölf OSDs, gleichmäßig verteilt. Für Hochverfügbarkeit, also das automatische Neustarten von VMs auf anderen Nodes, nennt sie ebenfalls mindestens drei Nodes für ein zuverlässiges Quorum.
Jeder Node hat standardmäßig eine Stimme. Verliert ein Teil des Clusters
das Quorum, schaltet er laut Doku in einen Nur-Lese-Modus. Für Ceph-Pools
gilt zusätzlich: Sind weniger als min_size Nodes erreichbar (Standard 2),
blockiert der Pool I/O, bis wieder genug Kopien da sind; betroffene Gäste
können dabei abstürzen.
Für zwei Nodes ohne Ceph bietet Proxmox das QDevice an: einen
externen Dienst (corosync-qnetd), der als dritte Stimme dient. Er läuft
auf einem beliebigen Linux-Rechner außerhalb des Clusters, verbindet sich
per TCP über Port 5403 und ist laut Doku nicht an die niedrigen
Latenzanforderungen von Corosync gebunden. Als gemeinsamer Speicher fehlt
dann allerdings Ceph. Eine verbreitete Alternative ist die
Storage-Replikation mit ZFS: Sie kopiert VM-Disks zeitgesteuert auf den
anderen Node, im kürzesten Intervall einmal pro Minute. Die Doku weist ausdrücklich
darauf hin, dass zwischen der letzten Synchronisation und dem Ausfall
geschriebene Daten verloren gehen können.
Für Cluster mit ungerader Node-Zahl rät Proxmox derzeit von einem QDevice ab: Es erhält dort mehrere Stimmen und wird damit praktisch zu einem Single Point of Failure.Herstellerangabe Vor dem Hinzufügen oder Entfernen von Nodes muss das QDevice laut Doku entfernt werden.
DRBD und LINSTOR #
DRBD repliziert Blockgeräte. Sein Quorum ist standardmäßig abgeschaltet und muss pro Ressource aktiviert werden; LINSTOR schaltet es automatisch ein, sobald mindestens zwei Nodes mit Daten und ein Node ohne Daten oder mindestens drei Nodes mit Daten an einer Ressource beteiligt sind.
Der DRBD-User-Guide schreibt, Quorum erfordere mindestens drei Nodes, der dritte könne aber ohne Datenträger als Schiedsrichter laufen; dafür könne sogar ein Raspberry Pi genügen.Herstellerangabe Dieser Diskless-Tiebreaker löst das Grundproblem von zwei Nodes: Trennt sich die Verbindung zwischen ihnen, behält die Seite, die den Tiebreaker noch erreicht, das Quorum, und die andere wird als veraltet markiert. Zwei Einschränkungen nennt die Doku:
- Ein Node, der das Quorum verloren hat, kann es nicht zurückgewinnen, indem er sich nur mit dem Diskless-Node verbindet.
- Der Schutz vor auseinanderlaufenden Daten hat Vorrang vor der Verfügbarkeit des Dienstes.
LINSTOR unterscheidet seit Server 1.34 zwei Arten von Diskless-Ressourcen:
Eine mit --drbd-diskless angelegte Ressource gibt ihrem Node eine Stimme
im Quorum, eine mit --drbd-client angelegte nicht. Laut LINSTOR-Guide behält in einem Cluster
aus zwei Nodes mit Daten und einem Diskless-Node mit Stimme eine Ressource
das Quorum, wenn ein Node mit Daten ausfällt.
Nach oben gibt es ebenfalls eine praktische Grenze: Eine DRBD-Ressource kann bis zu 32 Nodes umfassen, laut User Guide sind aber mehr als fünf in der Praxis nicht empfehlenswert; drei-, vier- oder fünffache Redundanz genüge in der Regel.
Longhorn #
Longhorn empfiehlt in seinen Best Practices mindestens drei Nodes. Die Standardzahl der Replikas pro Volume ist 3; die Settings-Referenz rät, bei drei oder mehr Storage-Nodes 3 zu verwenden, sonst 2. Ein einzelnes Replikat auf einem Ein-Node-Cluster sei möglich, aber ohne Hochverfügbarkeit.
Bei Longhorn kommt eine zweite Ebene dazu: Kubernetes selbst. Die Steuerungsebene speichert ihren Zustand in etcd, einer Datenbank, die ebenfalls per Mehrheit arbeitet. Die Kubernetes-Doku empfiehlt eine ungerade Zahl von etcd-Mitgliedern, für den Produktivbetrieb fünf, und einen etcd mit nur einem Mitglied nur für Tests. Ein Kubernetes-Cluster mit nur einem Steuerungs-Node bleibt also ein Single Point of Failure, egal wie viele Longhorn-Replikas es gibt.
GlusterFS #
GlusterFS kennt Replica-3-Volumes und als sparsamere Variante Replica 2 mit Arbiter: Ein dritter Brick speichert nur Dateinamen und Metadaten, keine Inhalte, und hilft so, Split Brain zu verhindern. Den alten Trick, zwei Replikas plus einen „Dummy“-Node für das Server-Quorum zu nutzen, beschreibt die Gluster-Doku als nicht ausreichend gegen Split Brain. Wichtiger für die Planung: GlusterFS ist für neue Deployments nach heutiger Faktenlage nicht mehr zu empfehlen; Einordnung und Alternativen stehen in GlusterFS: Architektur, Status und Alternativen.
Was ein Witness leistet und was nicht #
Ein Witness (auch Tiebreaker, Arbiter oder QDevice) ist ein Teilnehmer, der eine Stimme abgibt, aber keine Nutzdaten speichert. Er ist das billigste Mittel, aus zwei Stimmen drei zu machen.
Was er leistet:
- Bei einer Trennung zwischen zwei Daten-Nodes bekommt die Seite, die den Witness noch erreicht, die Mehrheit.
- Er braucht wenig Hardware: DRBD erwähnt einen Raspberry Pi, Ceph erlaubt einen Tiebreaker-Monitor als VM, und das Proxmox-QDevice darf sogar außerhalb des lokalen Netzes laufen.
Was er nicht leistet:
- Er ersetzt keine Datenkopie. Fällt einer der beiden Daten-Nodes aus, existieren die Daten nur noch einmal. Ein zweiter Ausfall in dieser Zeit bedeutet Datenverlust, wenn kein Backup existiert.
- Er darf nicht am selben Ort ausfallen. Läuft der Witness als VM auf einem der beiden Daten-Nodes, nimmt dieser Node bei seinem Ausfall zwei Stimmen mit, und der verbleibende Node hat keine Mehrheit. Der Witness gehört auf eigene Hardware.
- Er ist eine Stimme, kein Fencing. Ob die Minderheit wirklich anhält, regeln die Quorum-Einstellungen der Software, nicht der Witness.
Warum drei Nodes für Ceph knapp sind #
Drei Nodes sind das dokumentierte Minimum für Ceph und funktionieren. Wer
die Grenzen kennt, kann bewusst damit leben. Bei drei Nodes und size 3
liegt auf jedem Node genau eine Kopie jeder Placement Group. Daraus
folgt:
- Fällt ein ganzer Node aus, gibt es kein Ziel für die dritte Kopie.
Die betroffenen Placement Groups bleiben mit zwei Kopien „degraded“, bis
der Node zurückkommt oder ersetzt ist. Der Cluster bleibt wegen
min_size2 benutzbar, hat aber keine weitere Reserve. - Ein zweiter Ausfall in dieser Zeit stoppt I/O. Fällt in diesem Zustand ein weiterer Node oder auch nur ein OSD auf einem der beiden verbleibenden Nodes aus, haben einige Placement Groups zunächst nur noch eine Kopie, und Ceph blockiert für sie den Zugriff, bis wieder genug Kopien vorhanden sind.
- Fällt nur ein einzelnes OSD aus, kann Ceph die Kopien nur auf die übrigen OSDs desselben Hosts verteilen, weil auf den anderen Hosts schon je eine Kopie liegt. Dieser Host braucht also freien Platz für den Inhalt eines ganzen Datenträgers. Das ist eine Folge der Regel „jede Kopie auf einem anderen Host“; mit nur einem OSD pro Node gibt es dafür gar kein Ziel.
- Jede Wartung ist ein Zustand mit reduzierter Redundanz. Startest du einen Node für ein Update neu, läuft der Cluster in dieser Zeit mit zwei Kopien.
Ab vier Nodes ändert sich das: Fällt ein Node aus, markiert Ceph dessen OSDs nach einer Wartezeit als „out“ (laut Proxmox-Doku meist nach zehn Minuten) und legt die fehlenden Kopien auf den übrigen Hosts neu an. Der Cluster heilt sich also selbst und ist danach wieder gegen einen weiteren Ausfall geschützt, vorausgesetzt, es ist genug Platz frei (siehe nächster Abschnitt).
Ab fünf Nodes kommen zwei Vorteile hinzu. Mit fünf Monitoren übersteht das Quorum zwei Ausfälle, und die Ceph-Doku empfiehlt ab fünf Nodes genau das. Außerdem trägt jeder Node einen kleineren Anteil der Daten. Die Ceph-Doku rät ausdrücklich, den Anteil jedes Hosts an der Gesamtkapazität zu beachten: Trägt ein Host einen großen Anteil und fällt aus, kann die Recovery andere OSDs über die Füllgrenze treiben, und Ceph stoppt dann Schreibvorgänge, um Datenverlust zu verhindern. Mehr, kleinere Nodes verkleinern laut Doku die Auswirkung eines Ausfalls.
Du kannst diese Zustände im Replikation-und-Quorum-Simulator durchspielen: Nodes ausschalten, das Netz teilen und sehen, wer noch schreiben darf.
Kapazität: Reserve für einen Node-Ausfall #
Wer Selbstheilung will, muss Platz freihalten. Die Ceph-Doku nennt drei
Füllgrenzen, die beim Anlegen des Clusters gesetzt werden: Ab 85 Prozent
Belegung eines OSDs warnt Ceph (nearfull), ab 90 Prozent stoppt es das
Umverteilen auf dieses OSD (backfillfull), ab 95 Prozent nimmt es keine
Schreibvorgänge mehr an (full).
Daraus lässt sich ausrechnen, wie voll ein Cluster mit n gleich großen
Nodes vor einem Ausfall sein darf. Nach dem Ausfall verteilen sich
dieselben Daten auf n − 1 Nodes, die Belegung steigt also um den Faktor
n ÷ (n − 1). Damit sie danach unter der Warnschwelle von 85 Prozent
bleibt, darf sie vorher höchstens 0,85 × (n − 1) ÷ n betragen.
Rechnung unter diesen Annahmen: gleich große Nodes, gleichmäßige Verteilung, Warnschwelle 85 Prozent, ein Node fällt aus. Das ist eine Überschlagsrechnung; in Wirklichkeit gilt die Füllgrenze pro OSD, und die Verteilung ist nie ganz gleichmäßig.
| Nodes | Faktor nach Ausfall | höchste Belegung vorher |
|---|---|---|
| 3 | keine Recovery auf andere Hosts möglich (siehe oben) | Reserve für OSD-Ausfälle innerhalb eines Hosts |
| 4 | 4 ÷ 3 ≈ 1,33 | 0,85 × 3 ÷ 4 ≈ 64 % |
| 5 | 5 ÷ 4 = 1,25 | 0,85 × 4 ÷ 5 = 68 % |
| 6 | 6 ÷ 5 = 1,2 | 0,85 × 5 ÷ 6 ≈ 71 % |
| 7 | 7 ÷ 6 ≈ 1,17 | 0,85 × 6 ÷ 7 ≈ 73 % |
Dazu kommt der Platzverbrauch der Replikation selbst: Bei dreifacher Replikation bleibt von der Rohkapazität ein Drittel nutzbar. Ein Beispiel zum Nachrechnen: Fünf Nodes mit je 4 TB Rohkapazität ergeben 20 TB roh, davon 20 ÷ 3 ≈ 6,7 TB nutzbar; mit der Reserve von 68 Prozent solltest du davon rund 4,5 TB tatsächlich belegen. Diese Rechnung mit eigenen Werten, auch für Erasure Coding, erledigt der Storage-Cluster-Kapazitätsrechner.
Strom und Kosten pro Node #
Jeder zusätzliche Node bringt Anschaffungskosten, Stromverbrauch rund um die Uhr, Netzwerkports und Wartungsaufwand mit. Ein Witness dagegen kann auf sehr sparsamer Hardware laufen. Zwei Zusammenhänge helfen bei der Abwägung:
- Der Jahresverbrauch eines Clusters ist die Summe aller Nodes, Switches und Witness-Geräte. Der Rechenweg mit offen benannten Annahmen steht im Guide Stromverbrauch und Kosten eines Storage-Clusters.
- Mehr Nodes bedeuten bei gleicher Gesamtkapazität kleinere Nodes und, ab vier Nodes, eine prozentual kleinere Reserve für die Selbstheilung (siehe Tabelle oben). Drei große Nodes lassen sich zwar sogar voller planen, weil sie ohnehin nicht auf andere Hosts heilen können; dafür bleiben sie nach einem Ausfall ohne Reserve. Ob sich mehr kleinere Nodes rechnen, hängt von den Preisen ab, die du einsetzt.
Entscheidungshilfe #
| Wenn du … | dann … |
|---|---|
| zum Lernen Ausfälle üben willst | drei VMs auf einem Rechner; Node-Zahl ist hier egal, solange du die Zustände beobachtest |
| zwei Server hast und Blockspeicher replizieren willst | DRBD/LINSTOR mit Diskless-Tiebreaker auf eigener Hardware |
| zwei Proxmox-Server hast und VMs absichern willst | QDevice als dritte Stimme, Storage-Replikation mit ZFS und bewusstem Verlustfenster, dazu Backups |
| Ceph als gemeinsamen Speicher willst | mindestens drei möglichst gleiche Nodes; vier oder fünf, wenn Ceph nach einem Ausfall selbst heilen soll |
| Longhorn unter Kubernetes betreibst | drei Storage-Nodes und eine Steuerungsebene, die selbst ausfallsicher ist |
| zwei Ausfälle gleichzeitig überstehen willst | fünf Nodes bzw. fünf Monitore, plus ausreichend Platz für die Recovery |
Ob sich ein Storage-Cluster für deinen Zweck überhaupt lohnt oder ein NAS reicht, beleuchtet Wann lohnt sich ein Storage-Cluster wirklich?.
Ausprobieren: Quorum und Ausfälle nachvollziehen #
Am schnellsten verstehst du die Unterschiede, wenn du sie siehst:
- Im Simulator: Öffne den Quorum-Simulator, wähle nacheinander zwei Nodes, zwei Nodes mit Witness, drei und fünf Nodes, schalte Nodes aus und teile das Netz. Achte darauf, wann Quorum und wann Schreibrecht verloren gehen.
- In einer Testumgebung: Baue drei VMs auf, zum Beispiel nach dem Praxisprojekt Ceph-Testcluster mit drei VMs oder für DRBD nach Zwei Storage-Nodes mit Witness. Stoppe eine VM und beobachte die Zustände mit den lesenden Befehlen unten.
So prüfst du den Zustand #
Alle Befehle in diesem Abschnitt lesen nur.
Ceph: Die Statusübersicht zeigt, welche Monitore im Quorum sind und
wie viele OSDs up und in sind:
ceph -s
ceph health detail
ceph osd treeErwartet im gesunden Zustand: HEALTH_OK, alle Monitore im Quorum, alle
OSDs up und in, jeder Host im ceph osd tree mit seinen OSDs. Nach dem
Stoppen eines Nodes in der Testumgebung erwartest du HEALTH_WARN mit
Hinweisen auf ausgefallene OSDs und Placement Groups in Zuständen wie
degraded oder undersized.
Proxmox:
pvecm statusDie Ausgabe zeigt unter anderem „Expected votes“, „Total votes“ und „Quorum“. Laut Doku sieht ein Cluster aus zwei Nodes mit QDevice sinngemäß so aus:
Expected votes:   3
Total votes:      3
Quorum:           2
Flags: Quorate QdeviceDRBD und LINSTOR:
drbdadm status
linstor resource listSeit LINSTOR-Client 1.28 zeigt linstor resource list eine Spalte Vote;
ein automatisch angelegter Tiebreaker erscheint dort im Zustand
TieBreaker.
Longhorn:
kubectl -n longhorn-system get podDen Zustand einzelner Volumes (gesund, degraded) zeigt die Longhorn-Oberfläche.
Sicherheitshinweise #
pvecm expected 1nur zur Reparatur. Der Befehl setzt die erwarteten Stimmen eines Proxmox-Clusters auf 1 und hebt damit den Quorum-Schutz auf. Die Doku sieht ihn für Notfälle vor; in diesem Zustand sollen keine clusterverändernden Aktionen stattfinden. Läuft der andere Node in Wirklichkeit noch, riskierst du zwei unabhängige Datenstände.- Nie
min_size1 setzen. Proxmox warnt ausdrücklich: Ein Pool mitmin_size1 erlaubt Schreibzugriffe auf ein Objekt mit nur einer Kopie und kann zu Datenverlust, unvollständigen Placement Groups oder nicht auffindbaren Objekten führen. - Zwei Nodes nie ohne dritte Stimme automatisch umschalten lassen. Ohne Witness kann keine Seite sicher entscheiden. Automatische Regeln, die bei Split Brain einfach eine Seite gewinnen lassen, nennt der DRBD-User-Guide eine Konfiguration für potenziellen automatischen Datenverlust.
- Ausfälle nur in der Testumgebung simulieren. Netz trennen oder Nodes hart ausschalten gehört in VMs, nicht in den produktiven Cluster.
- Replikation ist kein Backup. Auch fünf Nodes schützen nicht vor versehentlichem Löschen oder Ransomware, siehe Replikation ist kein Backup.
Typische Denkfehler #
„Drei Nodes verhindern Split Brain.“ Nur zusammen mit Software, die die Mehrheitsregel durchsetzt, und mit Fencing bzw. Quorum-Einstellungen, die eine abgeschnittene Minderheit zuverlässig stoppen.
„Vier Nodes sind sicherer als drei.“ Für das Quorum nicht. Für Ceph ja, weil ein vierter Host als Ziel für neu angelegte Kopien dient.
„Der Witness kann auf einem der beiden Nodes laufen.“ Dann fällt er mit diesem Node aus, und der übrige Node hat keine Mehrheit. Der Witness braucht eigene Hardware.
„Mit Witness habe ich drei Kopien.“ Nein, ein Witness speichert keine Nutzdaten. Zwei Daten-Nodes bedeuten zwei Kopien.
„Ein voller Cluster ist effizient.“ Ein Cluster ohne freien Platz kann
sich nach einem Ausfall nicht selbst heilen und läuft im schlimmsten Fall
in die full-Grenze, ab der Ceph keine Schreibvorgänge mehr annimmt.
„Mehr Monitore sind immer besser.“ Die Ceph-Doku sagt, die meisten Cluster profitieren nicht von sieben oder mehr Monitoren, und Proxmox hält mehr als drei Monitore in kleinen bis mittleren Clustern für unnötig.
Offizielle Quellen #
- Ceph Docs (Tentacle): Monitor Config Reference: Paxos, Mehrheit, mindestens drei Monitore, Füllgrenzen.
- Ceph Docs (Tentacle): cephadm-Installation:
drei oder fünf Monitore,
--single-host-defaults. - Ceph Docs (Tentacle): Pool, PG and CRUSH Config Reference
und Pools:
size,min_size, Warnung vorsize2. - Ceph Docs (Tentacle): CRUSH Maps: Verteilung über Hosts.
- Ceph Docs (Tentacle): Hardware Recommendations: Anteil eines Hosts an der Kapazität, kleinere Nodes.
- Ceph Docs (Tentacle): Stretch Mode: zwei Standorte plus Tiebreaker.
- Proxmox VE: Deploy Hyper-Converged Ceph Cluster, Cluster Manager, High Availability und Storage Replication.
- DRBD 9.0 User Guide und LINSTOR User Guide: Quorum, Diskless-Tiebreaker, Auto-Quorum.
- Longhorn 1.13.0: Best Practices und Settings: drei Nodes, Replikazahl.
- Kubernetes: Operating etcd clusters: ungerade Mitgliederzahl, fünf für Produktion.
- Gluster Docs: Arbiter volumes and quorum options.
Weiterlesen #
- Replikation, Quorum und Split Brain: die Grundlagen hinter allen Zahlen in diesem Guide.
- Welche Hardware braucht ein Storage-Cluster?: wie du jeden der Nodes ausstattest.
- Storage-Cluster richtig planen: Node-Zahl, Kapazität, Netz und Betrieb in einer Planungs-Checkliste.
- Storage-Cluster im Homelab aufbauen: die Varianten mit zwei, drei und mehr Nodes als konkrete Lernpfade.
- Quorum-Simulator: Ausfälle und Netztrennungen gefahrlos durchspielen.
Quellen
Offizielle Dokumentation
Ceph Docs (Tentacle) — Monitor Config Reference (externer Link, neues Fenster)
Offizielle Dokumentation
Ceph Docs (Tentacle) — Deploying a new Ceph cluster (cephadm) (externer Link, neues Fenster)
Offizielle Dokumentation
Ceph Docs (Tentacle) — Pool, PG and CRUSH Config Reference (externer Link, neues Fenster)
Offizielle Dokumentation
Offizielle Dokumentation
Ceph Docs (Tentacle) — CRUSH Maps (externer Link, neues Fenster)
Offizielle Dokumentation
Ceph Docs (Tentacle) — Hardware Recommendations (externer Link, neues Fenster)
Offizielle Dokumentation
Ceph Docs (Tentacle) — Stretch Mode (externer Link, neues Fenster)
Offizielle Dokumentation
Proxmox VE Admin Guide — Deploy Hyper-Converged Ceph Cluster (externer Link, neues Fenster)
Offizielle Dokumentation
Proxmox VE Admin Guide — Cluster Manager (Quorum, QDevice) (externer Link, neues Fenster)
Offizielle Dokumentation
Proxmox VE Admin Guide — High Availability (externer Link, neues Fenster)
Offizielle Dokumentation
Proxmox VE Admin Guide — Storage Replication (externer Link, neues Fenster)
Hersteller
LINBIT — DRBD 9.0 User Guide (Quorum, Tiebreaker) (externer Link, neues Fenster)
Hersteller
LINBIT — LINSTOR User Guide 1.0 (Auto-Quorum) (externer Link, neues Fenster)
Offizielle Dokumentation
Longhorn Docs 1.13.0 — Best Practices (externer Link, neues Fenster)
Offizielle Dokumentation
Longhorn Docs 1.13.0 — Settings Reference (externer Link, neues Fenster)
Offizielle Dokumentation
Rook Docs — CephCluster CRD (Monitor-Anzahl) (externer Link, neues Fenster)
Offizielle Dokumentation
Kubernetes Docs — Operating etcd clusters for Kubernetes (externer Link, neues Fenster)
Offizielle Dokumentation
Gluster Docs — Arbiter volumes and quorum options (externer Link, neues Fenster)
Häufige Fragen
Kann ich einen Ceph-Cluster mit zwei Nodes betreiben?
Wo sollte der Witness laufen?
Bringen vier Nodes mehr Ausfallsicherheit als drei?
Wie viel Platz muss ich für einen Node-Ausfall freihalten?
Passt dazu
Werkzeug, Übung und eigene Messung zum Thema.
Teil der Themenwelt Storage Cluster – Verteilten Speicher verstehen und aufbauen · Abschnitt „Hardware, Netzwerk und Architektur“
Weiterlesen
- Storage ClusterFortgeschritten
Replikation, Quorum und Split Brain verständlich erklärt
Quorum, Witness, Fencing und Split Brain: warum drei Nodes allein nicht reichen, was CAP wirklich sagt und wie Ceph, DRBD und Proxmox reagieren.
- Storage ClusterEinsteiger
Welche Hardware braucht ein Storage-Cluster? Labor vs. Produktion
CPU je Dienst, RAM je OSD, SSDs mit Power-Loss-Protection, HBA statt RAID: was Ceph, Proxmox, LINSTOR und Longhorn laut Doku verlangen, für Labor und Betrieb.
- Storage ClusterEinsteiger
Was ist ein Storage-Cluster? Einfach erklärt mit Beispielen
Storage-Cluster verständlich erklärt: wie mehrere Server gemeinsam Speicher bereitstellen, was Scale-out, SDS und Shared Storage bedeuten, mit Beispiel.