Inhalt
Reality Check
Stand: Oktober 2026
- Belegt
- 6 Aussagen
Kurz gesagt: Replikation legt fest, wie oft und wo Daten liegen, Quorum legt fest, wer bei einer Störung entscheiden darf: nur eine Gruppe mit der Mehrheit aller Stimmen. Reißt das Netz zwischen den Nodes, entsteht eine Partition, und ohne Quorum könnten beide Seiten weiterschreiben. Das ist ein Split Brain mit zwei auseinanderlaufenden Datenständen. Drei Nodes verhindern das nicht automatisch, sondern nur, wenn die Software die Mehrheit erzwingt und die Minderheit per Fencing oder Watchdog sicher anhält. Damit wählen Systeme wie Ceph und DRBD im Sinne des CAP-Theorems Konsistenz: Die Minderheit wird unverfügbar, statt falsche Daten zu liefern.
Kaum ein Thema rund um Storage-Cluster wird so oft verkürzt wie dieses. „Nimm drei Nodes, dann gibt es kein Split Brain“ ist ein beliebter Ratschlag, aber nur die halbe Wahrheit. Dieser Guide erklärt, was Quorum tatsächlich leistet, wann es versagt, wozu Witness und Fencing da sind und wie die verbreiteten Systeme sich in den typischen Fehlerszenarien verhalten. Die Grundlagen der Datenverteilung aus Wie funktioniert verteilte Datenspeicherung? setzt er voraus.
Für wen ist dieser Guide? #
- Du planst einen Cluster mit Proxmox, Ceph, DRBD oder LINSTOR und willst verstehen, warum die Mindestanzahl der Nodes so wichtig ist.
- Du betreibst schon einen Cluster mit zwei Nodes und willst wissen, welches Risiko du damit eingehst.
- Du hast nach einem Netzwerkproblem einen Cluster erlebt, der „einfach stehen geblieben“ ist, und willst wissen, warum.
Voraussetzungen #
- Du kennst Replikation, Placement Groups und Fehlerdomänen aus Wie funktioniert verteilte Datenspeicherung?.
- Für die Praxisbeispiele hilft ein Testcluster in VMs, Pflicht ist er nicht. Alle Szenarien lassen sich auch im Quorum-Simulator durchspielen.
Was du lernst #
- was Replikationsfaktor, Mehrheit und Quorum genau bedeuten,
- warum ungerade Stimmenzahlen üblich sind und was ein Witness leistet,
- wie eine Netzwerkpartition entsteht und wie daraus ein Split Brain wird,
- unter welchen Bedingungen Quorum ein Split Brain wirklich verhindert,
- was Fencing und STONITH sind,
- was das CAP-Theorem aussagt und was nicht,
- wie Ceph, Proxmox, DRBD und GlusterFS in typischen Fehlerszenarien reagieren,
- wie du den Quorum-Zustand mit lesenden Befehlen prüfst.
Replikationsfaktor: wie viele Kopien wo liegen #
Der Replikationsfaktor beschreibt, wie viele vollständige Kopien eines Datenstücks existieren. Er beantwortet die Frage „Wie viele Ausfälle verträgt meine Datenhaltung?“. Bei drei Kopien in drei Fehlerdomänen dürfen zwei ausfallen, ohne dass Daten verloren sind.
Davon zu unterscheiden ist die Frage, ab wann ein System schreiben darf.
In Ceph regelt das min_size: Ein Pool mit size 3 und min_size 2 nimmt
Ein- und Ausgaben nur an, solange mindestens zwei Kopien erreichbar sind. Sind
es weniger, liegen die Daten zwar noch auf der verbleibenden Kopie, Ceph
bestätigt aber keine Zugriffe mehr. Die
Ceph-Doku warnt ausdrücklich, dass size 2 oder min_size 1 im
Produktivbetrieb Datenverlust riskiert und nur in Notfällen vorübergehend
gesetzt werden sollte.Belegt
Warum ist min_size 1 gefährlich? Weil dann ein einzelner verbliebener
Datenträger Schreibzugriffe annimmt, deren einzige Kopie er selbst ist. Fällt
er danach aus, sind diese Änderungen verloren, auch wenn die anderen Kopien
später zurückkommen. Proxmox formuliert es in seiner Ceph-Doku ebenso
deutlich und nennt als mögliche Folgen Datenverlust, unvollständige Placement
Groups und nicht mehr auffindbare Objekte.
Mehrheit und Quorum #
Quorum ist die Mindestzahl an Stimmen, die eine Gruppe braucht, um Entscheidungen für den ganzen Cluster treffen zu dürfen. Fast immer ist das die einfache Mehrheit: mehr als die Hälfte aller vorgesehenen Stimmen.
Rechnerisch: Anzahl der Stimmen halbiert, abgerundet, plus eins.
| Stimmen gesamt | Quorum | Stimmen, die ausfallen dürfen |
|---|---|---|
| 1 | 1 | 0 |
| 2 | 2 | 0 |
| 3 | 2 | 1 |
| 4 | 3 | 1 |
| 5 | 3 | 2 |
| 6 | 4 | 2 |
| 7 | 4 | 3 |
Zwei Dinge fallen auf. Erstens: Zwei Stimmen tolerieren keinen einzigen Ausfall, weil die verbleibende eine Stimme nicht mehr als die Hälfte ist. Zweitens: Eine gerade Anzahl bringt gegenüber der ungeraden darunter keinen Gewinn an Ausfalltoleranz. Vier Stimmen vertragen einen Ausfall, genau wie drei. Deshalb sind drei und fünf die üblichen Größen.
Ceph beschreibt das für seine Monitore genau so: Für einen Konsens über die Cluster-Karte braucht es eine Mehrheit der Monitore, also zum Beispiel zwei von drei, drei von fünf oder vier von sechs.Belegt Ceph empfiehlt für den Produktivbetrieb mindestens drei Monitore, ab fünf Nodes fünf. Proxmox weist jedem Node per Default eine Stimme zu und schaltet das Cluster-Dateisystem schreibgeschützt, sobald ein Node das Quorum verliert.
Zwei Arten von Quorum #
In der Praxis gibt es oft zwei Ebenen, die man auseinanderhalten muss.
Verwaltungs-Quorum. Wer darf den Zustand des Clusters ändern, also Konfiguration, Mitgliedschaft, Zuständigkeiten? Bei Ceph sind das die Monitore, bei Proxmox der Cluster-Stack corosync mit seinen Stimmen.
Daten-Quorum. Darf eine bestimmte Datenressource gerade beschrieben
werden? Bei Ceph entscheidet das je Placement Group über min_size, bei DRBD
die Quorum-Einstellung je Ressource.
Beide können unabhängig voneinander fehlen. Ein Ceph-Cluster kann ein vollständiges Monitor-Quorum haben, während ein Pool nicht schreibt, weil zu viele OSDs fehlen. Umgekehrt nützen erreichbare Kopien nichts, wenn die Monitore keine Mehrheit mehr haben.
Witness und Tiebreaker: die dritte Stimme ohne Daten #
Mit zwei Daten-Nodes gibt es kein Quorum, das einen Ausfall übersteht. Eine dritte Stimme muss aber nicht auch Daten speichern. Ein Witness (auch Tiebreaker oder Arbiter) stimmt nur mit ab.
| System | Name | Was laut Doku gilt |
|---|---|---|
| Proxmox VE | QDevice (corosync-qnetd auf einem externen Host) | empfohlen für Cluster mit zwei Nodes; für ungerade Node-Zahlen rät Proxmox derzeit ab |
| DRBD 9 | diskless Tiebreaker | ab DRBD 9.0.18; ein Node ohne Datenträger, der nur abstimmt |
| LINSTOR | diskless Ressource als Tiebreaker | LINSTOR kann einen solchen Tiebreaker automatisch hinzufügen |
| Ceph | Tiebreaker-Monitor im Stretch Mode | dritter Standort mit einem Monitor, der auch eine VM sein darf |
| GlusterFS | Arbiter-Brick | speichert nur Namen und Metadaten, keine Dateiinhalte |
Ein paar Feinheiten aus den Dokumentationen sind wichtig:
- Der Proxmox-QDevice verbindet sich über TCP und muss nicht im selben Netz mit derselben niedrigen Latenz liegen wie die Nodes. Bei einer ungeraden Node-Zahl bekäme er laut Proxmox so viele Stimmen, dass er quasi zum Single Point of Failure würde; deshalb dort keine Empfehlung.
- Bei DRBD kann ein Node, der sein Quorum verloren hat, es nicht dadurch zurückgewinnen, dass er sich allein mit dem diskless Tiebreaker verbindet.Belegt Der Tiebreaker entscheidet ein Patt, er macht aber keinen veralteten Node wieder zur gültigen Kopie.
- Ein Witness nützt nur, wenn er unabhängig ist. Steckt er in einer VM auf einem der beiden Daten-Nodes oder hängt er an derselben Steckdosenleiste, fällt er im ungünstigsten Fall gemeinsam mit diesem Node aus, und das Patt ist zurück.
Netzwerkpartition: wenn sich der Cluster teilt #
Eine Netzwerkpartition liegt vor, wenn die Nodes zwar laufen, sich aber nicht mehr alle gegenseitig erreichen. Ursachen sind ein defekter Switch, ein gezogenes Kabel, eine falsche VLAN-Konfiguration oder ein Netz, das unter Last Pakete verwirft. Für jeden Node sieht eine Partition zunächst genauso aus wie ein Ausfall der anderen: Sie antworten nicht mehr.
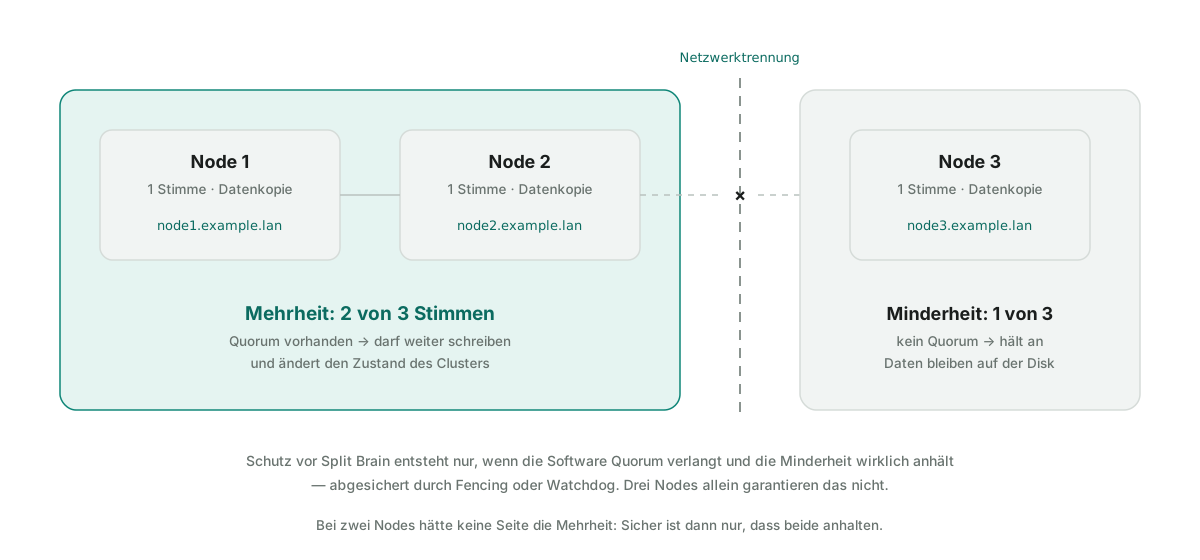
Bei drei Nodes und einer Trennung im Verhältnis 2 zu 1 ist die Lage eindeutig: Zwei Stimmen sind die Mehrheit, eine Stimme ist es nicht. Ein korrekt konfigurierter Cluster lässt die Zweiergruppe weiterarbeiten und hält den einzelnen Node an.
Problematisch wird es, wenn es keine Mehrheit gibt. Bei zwei Nodes sieht jede Seite nur eine von zwei Stimmen. Bei vier Nodes, die sich 2 zu 2 teilen, sieht jede Seite zwei von vier. Dann darf keine Seite weiterarbeiten. Das ist sicher, aber für die Verfügbarkeit ein Totalausfall.
Split Brain: zwei Wahrheiten #
Ein Split Brain entsteht, wenn nach einer Partition beide Seiten weiterschreiben. Jede Seite hält ihre Daten für die gültigen, die Datenstände laufen auseinander. Kommt die Verbindung zurück, gibt es zwei Versionen derselben Daten, und kein Automatismus weiß, welche richtig ist.
Der DRBD User Guide definiert es genau so: Beide Nodes waren während einer Trennung gleichzeitig Primary, also schreibend, und haben dadurch abweichende Datensätze erzeugt. DRBD unterscheidet dabei ausdrücklich zwischen einem Split Brain und einer bloßen Partition: Eine Partition ist das Netzproblem, ein Split Brain ist die Folge, wenn beide Seiten trotzdem schreiben. GlusterFS beschreibt ein Split Brain auf Dateiebene als Zustand, in dem die Kopien einer Datei voneinander abweichen und das System nicht mehr eindeutig bestimmen kann, welche Kopie die richtige ist.
Die Folgen sind ernst:
- Datenverlust beim Auflösen. Um wieder eine gemeinsame Version herzustellen, muss eine Seite ihre Änderungen aufgeben. Bei DRBD heißt der Node, dessen Änderungen verworfen werden, im User Guide „split brain victim“.
- Beschädigte Dateisysteme. Haben beide Seiten dasselbe Blockgerät mit einem gewöhnlichen Dateisystem beschrieben, ist das Ergebnis oft nicht mehr konsistent.
- Doppelte Dienste. Startet eine VM auf beiden Seiten gleichzeitig, schreiben beide Instanzen auf ihre jeweilige Kopie. Proxmox beschreibt in seiner HA-Doku, dass genau so eine Situation alle Daten einer VM zerstören kann.
Warum drei Nodes allein kein Split Brain verhindern #
Drei Nodes schaffen die Voraussetzung für eine eindeutige Mehrheit. Ob daraus Schutz wird, hängt an mehreren Bedingungen, die alle erfüllt sein müssen.
1. Die Software muss Quorum überhaupt verlangen. Das ist keine Selbstverständlichkeit. DRBD hat Quorum per Default ausgeschaltet.Belegt Ohne Quorum-Einstellung und ohne Fencing schreibt ein Primary auch dann weiter, wenn er die Verbindung zu seinen Partnern verloren hat. LINSTOR schaltet Quorum laut User Guide automatisch ein, sobald eine Ressource mindestens zwei Datenkopien plus einen diskless Teilnehmer oder drei Datenkopien hat, und darunter wieder ab. Prüfe also immer, was tatsächlich konfiguriert ist.
2. Die Minderheit muss wirklich anhalten. Quorum ist eine Regel. Wirksam
wird sie erst, wenn ein Node, der seine Mehrheit verliert, sofort aufhört zu
schreiben. DRBD bietet dafür die Reaktionen on-no-quorum io-error (laufende
Schreibzugriffe schlagen mit Fehler fehl) und on-no-quorum suspend-io
(Ein- und Ausgaben werden eingefroren). Proxmox setzt auf Self-Fencing:
Ein Node ohne Quorum kann seinen Watchdog nicht mehr zurücksetzen und startet
nach 60 Sekunden neu, wenn auf ihm HA-Dienste aktiv sind.
3. Die andere Seite darf erst übernehmen, wenn die Minderheit sicher gestoppt ist. Sonst laufen beide Seiten für einen Moment parallel. Proxmox beschreibt das in der HA-Doku als gefährliche Wettlaufsituation, wenn von beiden Nodes geschrieben wird. Deshalb wird erst übernommen, nachdem der ausgefallene Node als sicher abgeschaltet gilt.
4. Niemand umgeht die Regel von Hand. Für Notfälle gibt es Werkzeuge, die
das Quorum aushebeln: In Proxmox setzt pvecm expected 1 die erwarteten
Stimmen auf eins, bei DRBD erzwingt drbdadm primary --force die Primary-Rolle.
Auf der falschen Seite einer Partition ausgeführt, erzeugen sie genau das
Split Brain, das Quorum verhindern soll.
5. Die Stimmen müssen richtig verteilt sein. Ein Witness auf demselben Host wie ein Daten-Node, eine zu große Stimmenzahl für ein QDevice oder eine gerade Zahl von Nodes ohne Witness untergraben die Mehrheitsregel.
6. Das Netz muss stabil genug sein. Ein Netz, das unter Last Pakete verliert, erzeugt kurze, wiederholte Partitionen. Proxmox warnt, dass Recovery-Verkehr von Ceph die Cluster-Kommunikation von corosync so stören kann, dass das Cluster-Quorum verloren geht, und empfiehlt dafür getrennte, physisch eigene Netze.
Ein gutes Gegenbeispiel liefert GlusterFS: Die Gluster-Doku erklärt, dass ein Replica-2-Volume mit einem zusätzlichen Dummy-Node und Server-Quorum von 51 Prozent nicht verhindert, dass Dateien in ein Split Brain geraten.Belegt Mehr Nodes im Pool reichen also nicht; die Datenebene selbst muss die Mehrheit durchsetzen, bei Gluster etwa über Client-Quorum und Arbiter-Bricks.
Probiere das im Quorum-Simulator aus: Stelle drei Nodes ein, wähle eine Netztrennung und schalte dann in den Modus „Ohne Quorum“. Du siehst, dass trotz drei Nodes beide Seiten schreiben.
Fencing und STONITH #
Fencing heißt, einen Node, dessen Zustand unklar ist, gezielt von den gemeinsamen Ressourcen auszusperren, bevor ein anderer Node dessen Aufgaben übernimmt. Der Name kommt vom Zaun (fence), der um den Problemfall gezogen wird. Es gibt drei verbreitete Spielarten:
- Self-Fencing per Watchdog. Der Node überwacht sich selbst. Ein
Hardware- oder Software-Watchdog startet ihn neu, wenn er nicht regelmäßig
bestätigt, dass alles in Ordnung ist. Proxmox nutzt diesen Weg; ohne
Hardware-Watchdog fällt es auf den Linux-Software-Watchdog
softdogzurück, den Proxmox als zuverlässig, aber weniger unabhängig von der Hardware beschreibt. - STONITH (Shoot The Other Node In The Head). Ein anderer Node schaltet den Problemfall aktiv ab, etwa über eine schaltbare Steckdosenleiste oder die Fernwartungsschnittstelle des Servers. Der DRBD User Guide verlangt für Cluster-Dateisysteme ausdrücklich STONITH.
- Ressourcen-Fencing. Statt des ganzen Nodes wird nur der Zugriff auf eine
Ressource gesperrt. DRBD kennt dafür die Einstellung
fencing resource-onlymit einem Handler, der den Partner als veraltet markiert.
Fencing und Quorum ergänzen sich, können sich aber auch in die Quere kommen. Der DRBD User Guide rät im Pacemaker-Kapitel, entweder Fencing oder DRBD-Quorum zu konfigurieren, nicht beides, weil externe Fencing-Handler und das interne Quorum widersprüchlich reagieren können. Welche Kombination für dein Setup passt, steht in der Doku deiner Version.
Konsistenzmodelle in Kürze #
Um zu verstehen, was ein Cluster bei einer Partition opfert, hilft ein Blick auf Konsistenzmodelle.
- Starke Konsistenz (in der Theorie oft Linearisierbarkeit oder atomare Konsistenz genannt): Jede Operation scheint zu einem einzigen Zeitpunkt zwischen Anfrage und Antwort zu passieren. Wer nach einem bestätigten Schreibvorgang liest, sieht den neuen Wert, egal welche Kopie antwortet.
- Letztendliche Konsistenz (Eventual Consistency): Kopien dürfen kurz voneinander abweichen und gleichen sich später an. Lesen kann vorübergehend alte Werte liefern.
Block-Speicher für VMs und Datenbanken braucht starke Konsistenz, weil das Dateisystem im Gast sich darauf verlässt, dass ein bestätigter Block beim nächsten Lesen genau so zurückkommt. Deshalb arbeiten Ceph RBD und DRBD mit Protokoll C so, dass ein Schreibvorgang erst nach dem Speichern auf den beteiligten Kopien bestätigt wird.
Das CAP-Theorem, differenziert betrachtet #
Das CAP-Theorem wird oft als „Wähle zwei aus drei“ zusammengefasst. Das ist griffig, aber irreführend. Gilbert und Lynch, die das Theorem formal bewiesen haben, fassen es in ihrem Rückblick so: In einem Netz, in dem Nachrichten verloren gehen können, ist es unmöglich, einen Dienst zu bauen, der gleichzeitig atomare Konsistenz garantiert und auf jede Anfrage eine Antwort liefert.Belegt
Die drei Buchstaben bedeuten dabei:
- C (Consistency): jede Antwort ist korrekt im Sinne starker, atomarer Konsistenz.
- A (Availability): jede Anfrage an einen Node, der nicht ausgefallen ist, bekommt irgendwann eine Antwort.
- P (Partition tolerance): das System muss damit umgehen, dass das Netz Nachrichten verzögert oder verliert.
Daraus folgen einige Punkte, die in Kurzfassungen meist fehlen:
Partitionen sind keine Wahlmöglichkeit. Netze fallen aus, ob man will oder nicht. Die eigentliche Frage lautet: Was tut das System, während eine Partition besteht? Es kann entweder Konsistenz wahren und dafür auf einer Seite nicht mehr antworten, oder auf beiden Seiten antworten und dafür auseinanderlaufende Daten in Kauf nehmen.
Ohne Partition gilt die Abwägung so nicht. Solange alle Nodes sich erreichen, kann ein System konsistent und verfügbar zugleich sein. Der Haken steckt in der Erkennung: Ein Node kann nicht unterscheiden, ob ein Partner ausgefallen, abgetrennt oder nur sehr langsam ist. Gilbert und Lynch zeigen, dass ein System in einem Netz ohne feste Zeitgrenzen deshalb auch ohne tatsächliche Partition in dieselbe Lage geraten kann. In der Praxis lösen Systeme das mit Timeouts: Wer zu lange nicht antwortet, wird behandelt, als wäre er abgetrennt.
„Availability“ im CAP-Sinn ist nicht dasselbe wie Hochverfügbarkeit. Ein System, das sich für Konsistenz entscheidet, bleibt für alle Clients auf der Mehrheitsseite voll nutzbar. Unverfügbar wird nur die Minderheit. Im Alltag eines Clusters mit drei Nodes und einer 2-zu-1-Trennung merken die meisten Anwendungen davon wenig, solange sie auf der Mehrheitsseite laufen.
Im Normalbetrieb heißt die Abwägung eher Latenz gegen Konsistenz. Synchrone Replikation wartet bei jedem Schreibvorgang auf die Bestätigung der anderen Kopien. Das kostet Zeit, auch ohne jede Störung. DRBD macht diese Wahl mit seinen Protokollen A, B und C ausdrücklich: Protokoll C wartet, bis auch der Partner auf Platte geschrieben hat, Protokoll A nicht. Mit dem CAP-Theorem selbst hat das nur mittelbar zu tun.
Manche Systeme opfern beides. Gilbert und Lynch weisen darauf hin, dass ein System auch bewusst sowohl Konsistenz als auch Verfügbarkeit nur eingeschränkt liefern kann, wenn das zum Anwendungsfall besser passt.
Wie sich die Systeme entscheiden #
| System | Verhalten bei Partition | CAP-Einordnung |
|---|---|---|
| Ceph (Monitore und Pools) | Monitore ohne Mehrheit treffen keine Entscheidungen; Pools bedienen keine Zugriffe unterhalb von min_size | Konsistenz vor Verfügbarkeit |
| Proxmox-Cluster (corosync) | Node ohne Quorum: Cluster-Dateisystem schreibgeschützt, HA-Nodes fencen sich selbst | Konsistenz vor Verfügbarkeit |
DRBD mit quorum majority | Seite ohne Quorum: Schreibfehler oder eingefrorene Ein- und Ausgaben | Konsistenz vor Verfügbarkeit |
| DRBD ohne Quorum | beide Seiten können Primary werden, Split Brain möglich | Verfügbarkeit vor Konsistenz, mit manueller Auflösung |
| GlusterFS mit Client-Quorum | ohne Quorum wird das Replica-Set per Default schreibgeschützt | Konsistenz vor Verfügbarkeit |
Der DRBD User Guide formuliert die Haltung für seinen Tiebreaker unmissverständlich: Schutz vor auseinanderlaufenden Daten hat immer Vorrang vor der Verfügbarkeit des Dienstes.
Fehlerszenarien im Vergleich #
Die folgende Tabelle fasst zusammen, was in typischen Aufbauten bei einer Störung passiert. Sie setzt korrekt konfiguriertes Quorum und funktionierendes Fencing voraus. Spiele jede Zeile im Quorum-Simulator nach.
| Aufbau | Störung | Ergebnis |
|---|---|---|
| 2 Nodes, kein Witness | ein Node fällt aus | verbleibender Node hat 1 von 2 Stimmen, kein Quorum, hält an |
| 2 Nodes, kein Witness | Netztrennung | beide Seiten ohne Quorum, beide halten an; ohne Quorum-Regel droht Split Brain |
| 2 Nodes + Witness | ein Daten-Node fällt aus | anderer Daten-Node plus Witness: 2 von 3, arbeitet weiter |
| 2 Nodes + Witness | Netztrennung zwischen den Daten-Nodes | die Seite, der der Witness seine Stimme gibt, arbeitet weiter; die andere hält an |
| 2 Nodes + Witness | Witness fällt aus | beide Daten-Nodes: 2 von 3, arbeiten weiter, aber ohne Reserve |
| 3 Nodes | ein Node fällt aus | 2 von 3, arbeitet weiter; bei Ceph mit size 3 degradiert, aber schreibfähig |
| 3 Nodes | Trennung 2 zu 1 | Zweiergruppe arbeitet weiter, Einzelnode hält an |
| 3 Nodes | zwei Nodes fallen aus | 1 von 3, kein Quorum, alles hält an; Daten bleiben erhalten |
| 4 Nodes | Trennung 2 zu 2 | keine Seite hat die Mehrheit, beide halten an |
| 5 Nodes | Trennung 3 zu 2 | Dreiergruppe arbeitet weiter, Zweiergruppe hält an |
Zu den Zeilen mit Witness gibt es bei DRBD eine Feinheit: Laut DRBD User Guide läuft bei einer Trennung zwischen Primary und Secondary der Primary mit dem Tiebreaker weiter, der Secondary wird als veraltet markiert. Verliert der Primary danach zusätzlich den Tiebreaker, verliert auch er sein Quorum.
Eine zweite Feinheit betrifft die Zeile „zwei Nodes fallen aus“: DRBD zählt
Nodes, die den Cluster geordnet verlassen haben (etwa per
drbdadm down für eine Wartung) und ihre Daten dabei als veraltet markiert
haben, anders als ausgefallene. Der User Guide nennt das „Last man standing“:
Sind alle anderen geordnet gegangen, darf der letzte verbliebene Node das
Quorum behalten. Bei einem echten Ausfall gilt das nicht.
Praxis: Quorum-Zustand prüfen #
Die folgenden Befehle lesen nur. Sie folgen den offiziellen Dokumentationen von Ceph 20.2 Tentacle, Proxmox VE 9.2 und DRBD 9, Stand Oktober 2026. LabKompass hat sie für diesen Guide nicht selbst ausgeführt. Gleiche sie vor dem Einsatz mit der Doku deiner Version ab und übe Ausfallszenarien zuerst in einer Testumgebung.
Ceph #
ceph -s
ceph mon stat
ceph quorum_status
ceph health detailceph -s zeigt im Abschnitt zu den Monitoren, wie viele im Quorum sind.
ceph mon stat zeigt die Monitor-Karte, ceph quorum_status den
Quorum-Zustand im Detail. Meldet ceph health detail den Check MON_DOWN,
ist mindestens ein Monitor nicht erreichbar; laut Ceph-Doku braucht der
Cluster dann weiterhin mehr als die Hälfte der vorgesehenen Monitore.
Für die Daten-Ebene prüfst du die Pools:
ceph osd pool ls detail
ceph osd pool get testpool min_sizeErsetze testpool durch deinen Poolnamen. Steht min_size auf 1, solltest du
den Grund kennen.
Proxmox VE #
pvecm statusDie Ausgabe enthält unter anderem die erwarteten Stimmen, die vorhandenen Stimmen, das nötige Quorum und Flags. Schematisch, nicht als echte Ausgabe zu lesen, für zwei Nodes mit QDevice laut Proxmox-Doku:
Expected votes:   3
Total votes:      3
Quorum:           2
Flags: Quorate QdeviceQuorate heißt, dass dieser Node Teil einer Gruppe mit Quorum ist.
DRBD und LINSTOR #
drbdadm status <ressource>zeigt Rolle, Datenträgerzustand und Verbindungen einer Ressource. Ob Quorum
überhaupt eingeschaltet ist, siehst du in der Ressourcen-Konfiguration im
Abschnitt options. Laut DRBD User Guide sieht eine Ressource mit Quorum so
aus:
resource quorum-demo {
  options {
    quorum majority;
    on-no-quorum io-error;
  }
}Mit LINSTOR zeigt linstor resource list ab Client 1.28 eine Spalte Vote,
an der du erkennst, welche Ressourcen mit abstimmen:
linstor resource listAusfälle sicher üben #
Netztrennungen übst du ausschließlich in einer Testumgebung aus VMs, zum Beispiel im Praxisprojekt Zwei Storage-Nodes mit Witness. Trenne dort die virtuelle Netzwerkkarte einer VM im Hypervisor, beobachte mit den lesenden Befehlen oben, was die Mehrheit und was die Minderheit tut, und verbinde sie danach wieder. Ändere während des Tests keine Quorum-Einstellungen.
Sicherheitshinweise #
- Quorum nie abschalten, um Verfügbarkeit zu retten. Ein Cluster, der mangels Quorum anhält, schützt gerade deine Daten. Erst die Ursache finden, dann handeln.
- Notfallbefehle nur mit vollständigem Lagebild.
pvecm expected 1unddrbdadm primary --forceumgehen den Schutz. Nutze sie nur, wenn du sicher weißt, dass die andere Seite wirklich aus ist, und nie auf beiden Seiten. Die Proxmox-Doku warnt, in diesem Zustand keine Änderungen am Cluster vorzunehmen. --discard-my-dataverwirft Daten. Beim Auflösen eines DRBD-Split-Brain verbindet der unterlegene Node mit dieser Option neu und verliert dabei alle Änderungen seit der Trennung. Sichere diese Seite vorher, wenn du ihre Änderungen brauchen könntest, und prüfe zweimal, auf welchem Node du den Befehl ausführst. Den vollständigen Ablauf beschreibt Storage-Cluster-Troubleshooting.- Automatische Split-Brain-Auflösung ist automatischer Datenverlust. DRBD bietet Richtlinien, die bei einem Split Brain automatisch eine Seite verwerfen. Der DRBD User Guide sagt selbst, dass man damit potenziellen automatischen Datenverlust konfiguriert, und empfiehlt stattdessen Fencing, Quorum und redundante Kommunikationswege.
- Witness unabhängig betreiben. Eigene Stromversorgung, eigener Netzweg, nicht als VM auf einem der Daten-Nodes.
- Getrennte Netze für Cluster-Kommunikation. Proxmox empfiehlt für corosync ein eigenes, physisch getrenntes Netz und rät davon ab, corosync und Storage über dasselbe Netz zu führen, außer als Fallback mit niedriger Priorität.
So prüfst du, ob es geklappt hat #
Ein gesunder Cluster mit wirksamem Quorum zeigt:
- Ceph: Alle Monitore stehen im Quorum,
ceph health detailmeldet keinenMON_DOWN, alle Pools habenmin_sizevon mindestens 2. - Proxmox:
pvecm statuszeigtQuorate, die Zahl der vorhandenen Stimmen entspricht den erwarteten. - DRBD: Alle Ressourcen sind verbunden, die Datenträger
UpToDate, und in der Konfiguration istquorum majoritygesetzt oder LINSTOR hat Quorum automatisch aktiviert. - Dein Verständnis: Du kannst für deinen Aufbau sagen, welche Seite bei einer Trennung weiterarbeitet und warum die andere anhält.
Typische Probleme #
Zwei-Node-Cluster bleibt nach dem Ausfall eines Nodes stehen. Das ist kein Fehler, sondern Quorum. Der verbliebene Node hat eine von zwei Stimmen. Die Lösung ist eine dritte Stimme, also ein Witness, nicht das Abschalten der Regel. Wie viele Nodes du je Technologie brauchst, steht in Zwei, drei oder fünf Nodes?.
Proxmox: /etc/pve ist plötzlich schreibgeschützt. Der Node hat das
Cluster-Quorum verloren. Prüfe mit pvecm status, welche Nodes er sieht, und
suche die Ursache im Netz.
DRBD meldet nach einer Störung StandAlone. Häufig ein erkanntes Split
Brain. Laut User Guide steht im Log dann die Meldung
Split-Brain detected, dropping connection!. Nicht hektisch neu verbinden,
sondern zuerst klären, welche Seite die gültigen Daten hat.
Ceph meldet MON_DOWN oder Uhrzeitabweichungen. Monitore brauchen eine
Mehrheit und synchrone Uhren. Ceph warnt mit MON_CLOCK_SKEW, wenn die Uhren
der Monitor-Hosts zu weit auseinanderliegen, und empfiehlt chrony oder ntpd.
Cluster verliert sporadisch das Quorum unter Last. Oft teilen sich Storage-Recovery und Cluster-Kommunikation ein Netz. Trenne die Netze oder richte für corosync einen zweiten Link ein. Proxmox nennt für den Cluster-Stack eine Latenz unter 5 Millisekunden zwischen allen Nodes als Voraussetzung für stabilen Betrieb.
Ceph-Pool schreibt nicht, obwohl alle Monitore laufen. Die Daten-Ebene
hat ihr eigenes Quorum: Zu viele OSDs sind ausgefallen, min_size ist
unterschritten. ceph health detail nennt die betroffenen Placement Groups.
Offizielle Quellen #
- Gilbert, Lynch: Perspectives on the CAP Theorem
- Ceph Monitor Config Reference (Tentacle)
- Ceph Pools (Tentacle)
- Ceph Monitoring a Cluster (Tentacle)
- Ceph Stretch Clusters (Tentacle)
- Proxmox VE: Cluster Manager
- Proxmox VE: High Availability
- DRBD 9.0 User Guide
- LINSTOR User Guide 1.0
- Gluster Docs: Arbiter volumes and quorum options
Weiterlesen #
- Zwei, drei oder fünf Nodes?: welche Mindestkonfiguration Ceph, Proxmox, DRBD und Longhorn brauchen.
- Hochverfügbarkeit im Storage-Cluster: wie Failover, Fencing und Wartung in der Praxis zusammenspielen.
- LINSTOR und DRBD verstehen: Quorum und Tiebreaker in der Blockreplikation im Detail.
- Praxisprojekt: Zwei Storage-Nodes mit Witness: Partitionen und ein Split Brain gefahrlos in VMs üben.
Quellen
Originalpaper · 2012
Gilbert, Lynch — Perspectives on the CAP Theorem (externer Link, neues Fenster) — Seth Gilbert, Nancy A. Lynch
Offizielle Dokumentation
Ceph Docs (Tentacle) — Monitor Config Reference (externer Link, neues Fenster)
Offizielle Dokumentation
Offizielle Dokumentation
Ceph Docs (Tentacle) — Monitoring a Cluster (externer Link, neues Fenster)
Offizielle Dokumentation
Ceph Docs (Tentacle) — Stretch Clusters (externer Link, neues Fenster)
Offizielle Dokumentation
Proxmox VE Admin Guide — Cluster Manager (externer Link, neues Fenster)
Offizielle Dokumentation
Proxmox VE Admin Guide — High Availability (externer Link, neues Fenster)
Offizielle Dokumentation
Offizielle Dokumentation
LINBIT — LINSTOR User Guide 1.0 (externer Link, neues Fenster)
Offizielle Dokumentation
Gluster Docs — Arbiter volumes and quorum options (externer Link, neues Fenster)
Häufige Fragen
Verhindern drei Nodes ein Split Brain?
Was ist der Unterschied zwischen Quorum und Replikation?
Was ist ein Witness oder Tiebreaker?
Was sagt das CAP-Theorem für Storage-Cluster?
Wie löse ich ein Split Brain auf?
Passt dazu
Werkzeug, Übung und eigene Messung zum Thema.
Teil der Themenwelt Storage Cluster – Verteilten Speicher verstehen und aufbauen · Abschnitt „Grundlagen verteilter Speichersysteme“
Weiterlesen
- Storage ClusterEinsteiger
Was ist ein Storage-Cluster? Einfach erklärt mit Beispielen
Storage-Cluster verständlich erklärt: wie mehrere Server gemeinsam Speicher bereitstellen, was Scale-out, SDS und Shared Storage bedeuten, mit Beispiel.
- Storage ClusterEinsteiger
Storage-Cluster vs. NAS vs. SAN: Unterschiede und Einsatz
NAS, SAN oder Storage-Cluster? Architektur, Ausfallsicherheit, Skalierung, Kosten und Verwaltungsaufwand im Vergleich, für Homelab und kleine Firmen.
- Storage ClusterEinsteiger
Wie funktioniert verteilte Datenspeicherung? Einfach erklärt
Wie ein Storage-Cluster entscheidet, wo Daten liegen: Hashing und CRUSH, Metadaten, Replikation, Erasure Coding, Konsistenz und Fehlerdomänen erklärt.